 张雪随笔
4.JUC之二-并发集合
1.AQS
1.1.基础概念
aqs原理:
- https://www.cnblogs.com/NathanYang/p/9944632.html
- https://www.cnblogs.com/NathanYang/p/9944632.html
- https://blog.csdn.net/striveb/article/details/86761900
AQS是AbstractQueuedSynchronizer的简称,本身是抽象类,为其他同步的工具提供基础能力,是concurrent包下类的核心
1.2.数据结构
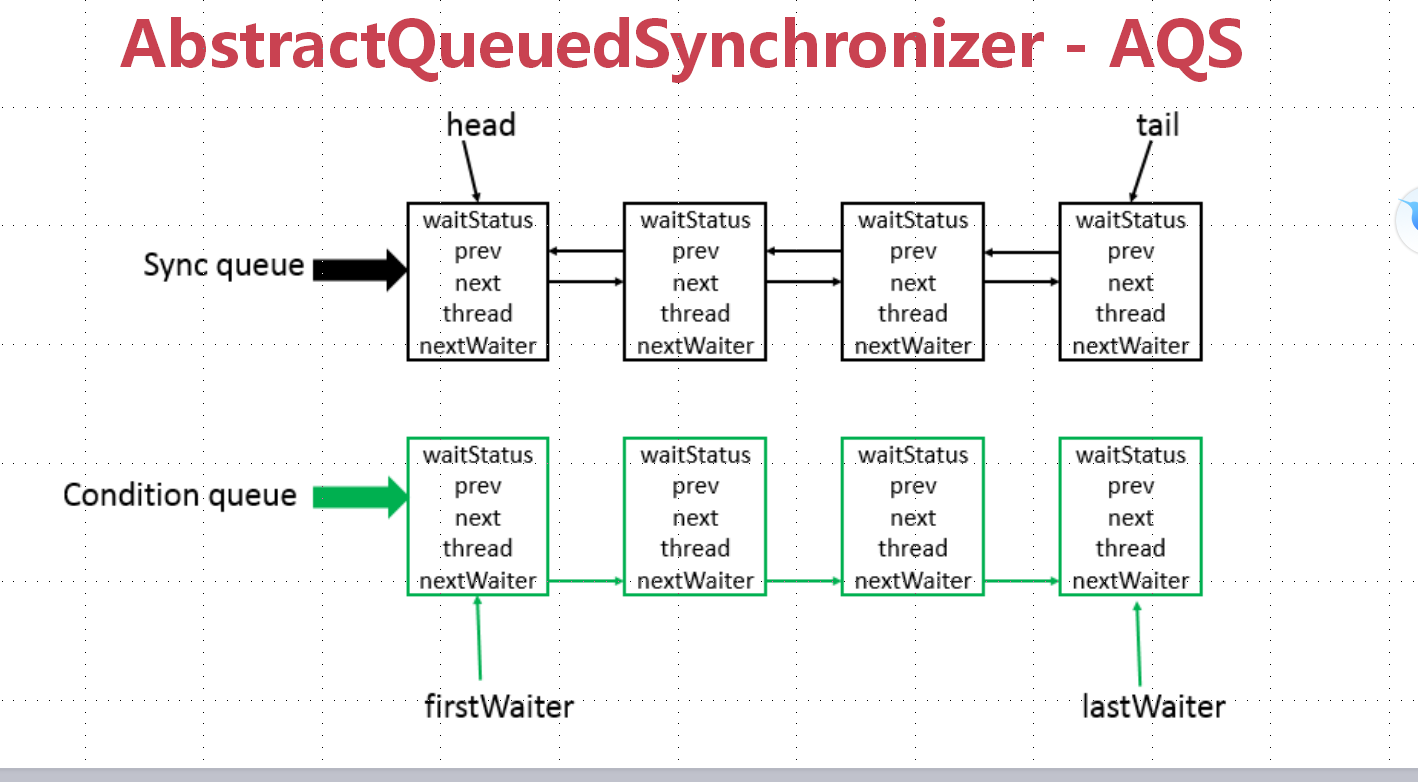
AQS全称 AbstractQueuedSynchronizer。是JUC包下很多并发工具的实现基础,由两部分 数据组成
- state,是int类型的,代表了加锁的状态,通过CAS修改state。当state=0时 表示无锁;当state=1时加锁成功;当state>1时表示重入锁重入次数。
- 双向列表。保存需要执行任务的线程,以及任务状态。
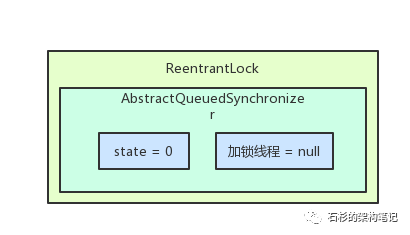
使用LockSupport控制正在排队的线程等待获得机会去获得锁。
1.3.实现原理
- 锁的类型提供了独占锁与共享锁,可以继承AQS实现相关抽象方法。AQS采用模板模式封装好加锁/解锁的逻辑。
- aqs默认实现的是非公平锁。线程尝试获得锁失败后,会将线程与等待的状态封装为node对象,使用CAS的方式保存到队尾,调用park阻塞任务线程,等待释放后唤醒。
- 头节点释放同步状态后,将会唤醒其后继节点,后继节点被唤醒后需要检查前一个节点的状态,并尝试获得锁(采用非公平锁唤醒后还是要竞争)。
双向链表的头结点,在抢锁成功后,会将线程的引用为null,方便GC回收垃圾。
双向链向前是为了方便实现中断,当节点被唤醒后能够检测前面节点的状态,如果是已经被取消的,就可以移除前面的节点,让自己更快获得锁。 向后是也为了方便唤醒后续阻塞的线程。
1.4.任务状态
- CANCELLED=1;因为超时或者中断,节点会被设置为取消状态,被取消的节点时不会参与到竞争中的,他会一直保持取消状态不会转变为其他状态;
- SIGNAL=-1;后继节点的线程处于等待状态,而当前节点的线程如果释放了同步状态或者被取消,将会通知后继节点,使后继节点的线程得以运行
- CONDITION=-2;节点在等待队列中,节点线程等待在Condition上,当其他线程对Condition调用了signal()后,改节点将会从等待队列中转移到同步队列中,加入到同步状态的获取中
- PROPAGATE=-3;表示下一次共享式同步状态获取将会无条件地传播下去
1.5.同步模式
- Exclusive(独占,只有一个线程能执行,如ReentrantLock)
- Share(共享,多个线程可同时执行,如Semaphore/CountDownLatch)
1.6.核心方法
- 关于state的方法主要有一下三种
getState():返回同步状态的当前值; setState(int newState):设置当前同步状态; compareAndSetState(int expect, int update):使用CAS设置当前状态,该方法能够保证状态设置的原子性; - 自定义同步器实现时主要实现以下几种方法
tryAcquire(int arg):独占式获取同步状态,获取同步状态成功后,其他线程需要等待该线程释放同步状态才能获取同步状态 tryRelease(int arg):独占式释放同步状态; tryAcquireShared(int arg):共享式获取同步状态,返回值大于等于0则表示获取成功,否则获取失败; tryReleaseShared(int arg):共享式释放同步状态; isHeldExclusively():当前同步器是否在独占式模式下被线程占用,一般该方法表示是否被当前线程所独占; - 其余方法 ```java //独占式获取同步状态 acquire(int arg):独占式获取同步状态,如果当前线程获取同步状态成功,则由该方法返回,否则,将会进入同步队列等待,该方法将会调用可重写的tryAcquire(int arg)方法; acquireInterruptibly(int arg):与acquire(int arg)相同,但是该方法响应中断,当前线程为获取到同步状态而进入到同步队列中,如果当前线程被中断,则该方法会抛出InterruptedException异常并返回; tryAcquireNanos(int arg,long nanos):超时获取同步状态,如果当前线程在nanos时间内没有获取到同步状态,那么将会返回false,已经获取则返回true;
//共享式获取同步状态 acquireShared(int arg):共享式获取同步状态,如果当前线程未获取到同步状态,将会进入同步队列等待,与独占式的主要区别是在同一时刻可以有多个线程获取到同步状态; acquireSharedInterruptibly(int arg):共享式获取同步状态,响应中断; tryAcquireSharedNanos(int arg, long nanosTimeout):共享式获取同步状态,增加超时限制;
//释放同步状态 release(int arg):独占式释放同步状态,该方法会在释放同步状态之后,将同步队列中第一个节点包含的线程唤醒; releaseShared(int arg):共享式释放同步状态;
### 1.7.并发容器

JUC其实指的是java.util.concurrent包下的并发集合类,都是使用lock机制实现的线程安全的集合。相比同步容器,并发容器的效率更高,操作跟简单。

1. 以concurrent开头的集合类

```java
//默认是支持16个线程并发写入,当超过了16个的时候,可能有些线程是需要等待的。它可以设置initialCapacity,设置线程数量
ConcurrentHashMap<K, V>

ConcurrentLinkedDeque<E>

//当使用多个线程访问集合的时候,这个集合是很好的选择。它不允许null,他实现了多线程的高效访问,访问时无需等待。
ConcurrentLinkedQueue<E>

ConcurrentNavigableMap<K, V>

ConcurrentSkipListMap<K, V>
concurrent的集合支持多个线程并发写入访问,写入的时候所有的操作都是线程安全的,但读取的时候不必锁定。 这些集合类采用更加复杂的算法保证远不会锁住整个集合,因此在并发写入的时候有较好的性能。
- 以CopyOnWrite开头的集合类
CopyOnWriteArrayList<E>

CopyOnWriteArraySet<E>

CopyOnWriteArraySet它的底层实现是CopyOnWriteArrayList,所以他们的实现原理是相同的。
他们的实现原理:复制底层的数组的方式,来实现写的操作。
当读取集合的时候,线程直接读取集合本身,无需加锁和阻塞。
当写入集合的时候,该集合底层会复制一份新的数组,接下来的操作是对新的数据。整个过程是对原集合的副本进行的,所以线程是安全的。
但是,他的写入时对数组的操作,所以写入到时候,性能是比较差的。但是读取是直接读取原数组,且不需要加锁,因此操作是很快,很安全的。
这两个类适用于读取操作很多的场合。
2.CopyOnWriteArrayList
2.1.介绍
CopyOnWrite,顾名思义:每次都是从主内存中获得最新的数组,copy一个新的数组,程序是操作这个新的数组的值,再将数组赋值给集合。
这样做的好处是读操作不加锁的,为了防止写的操作影响读操作
CopyOnWriteArrayList的add()方法
public boolean add(E e) {
    // 获取独占锁
    final ReentrantLock lock = this.lock;
    lock.lock();
    try {
        // 获取array
        Object[] elements = getArray();
        // 复制array到新数组,添加元素到新数组
        int len = elements.length;
        Object[] newElements = Arrays.copyOf(elements, len + 1);
        newElements[len] = e;
        // 替换数组
        setArray(newElements);
        return true;
    } finally {
        // 释放锁
        lock.unlock();
    }
}
CopyOnWriteArrayList 内部维护了一个数组,成员变量 array 就指向这个内部数组,所有的读操作都是基于新的array对象进行的。
因为上了独占锁,所以如果多个线程调用add()方法只有一个线程会获得到该锁,其他线程被阻塞,知道锁被释放, 由于加了锁,所以整个操作的过程是原子性操作
CopyOnWriteArrayList 会将 新的array复制一份,然后在新复制处理的数组上执行增加元素的操作,执行完之后再将复制的结果指向这个新的数组。
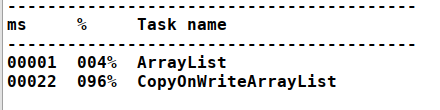
CopyOnWriteArrayList在单线程的情况下,性能远远低于ArrayList
2.2.优缺点
优点:
- 读写分离
- 最终数据结果的一致性(弱一致性)
缺点:
- 写操作会复制一个数组出来,频繁的调用写操作,不仅浪费CPU资源,会导致出现大量的GC。影响JVM的性能。
- 因为写操作是加锁的,读操作不加锁,这样就导致了,多线程操作的时候,读取到的数据可能不是最新的,实时性差。
- 性能不好,写操作消耗的计算机资源较多,如果集合的内容较大,在频繁的调用写操作时会严重影响JVM的性能
- 弱一致性。是优点也是缺点
- 迭代器不支持增删改
所以CopyOnWriteArrayList适合读多写少的场景
2.3.【缺点】弱一致性
调用iterator方法获取迭代器返回一个COWIterator对象
COWIterator的构造器里主要是 保存了当前的list对象的内容和遍历list时数据的下标。
snapshot是list的快照信息,因为CopyOnWriteArrayList的读写策略中都会使用getArray()来获取一个快照信息,生成一个新的数组。
所以在使用该迭代器元素时,其他线程对该lsit操作是不可见的,因为操作的是两个不同的数组所以造成弱一致性。
代码如下:
public Iterator<E> iterator() {
    return new COWIterator<E>(getArray(), 0);
}

static final class COWIterator<E> implements ListIterator<E> {

    /** Snapshot of the array */
    private final Object[] snapshot;
    /** Index of element to be returned by subsequent call to next.  */
    private int cursor;

    private COWIterator(Object[] elements, int initialCursor) {
        cursor = initialCursor;
        snapshot = elements;
    }

    public boolean hasNext() {
        return cursor < snapshot.length;
    }

    public boolean hasPrevious() {
        return cursor > 0;
    }

    @SuppressWarnings("unchecked")
    public E next() {
        if (!hasNext())
            throw new NoSuchElementException();
        return (E) snapshot[cursor++];
    }
}
2.4.【缺点】迭代器不支持增删改
CopyOnWriteArrayList 迭代器是只读的,不支持增删操作
CopyOnWriteArrayList迭代器中的 remove()和 add()方法,没有支持增删而是直接抛出了异常
因为迭代器遍历的仅仅是一个快照,而对快照进行增删改是没有意义的。
// 尝试使用iterator删除元素,结果报错了。这个和ArrayList不一样???
private static void CopyOnWriteArrayListTest(){
    CopyOnWriteArrayList<String> list = new CopyOnWriteArrayList<>();
    list.add("test1");
    list.add("test2");
    list.add("test3");
    list.add("test4");

    Iterator<String> iterator = list.iterator();

    while (iterator.hasNext()){
        if ("test1".equals(iterator.next())){
            iterator.remove();
        }
    }

    System.out.println(list.toString());
}

Exception in thread "main" java.lang.UnsupportedOperationException
 at java.util.concurrent.CopyOnWriteArrayList$COWIterator.remove(CopyOnWriteArrayList.java:1178)
3.CopyOnWriteArraySet
3.1.对比HashSet
因为CopyOnWriteArraySet底层的实现使用的是CopyOnWriteArrayList,所以数据是有序的,且支持排序。
在执行Add/remove操作的时候,调用的还是CopyOnWriteArrayList的addIfAbsent方法。
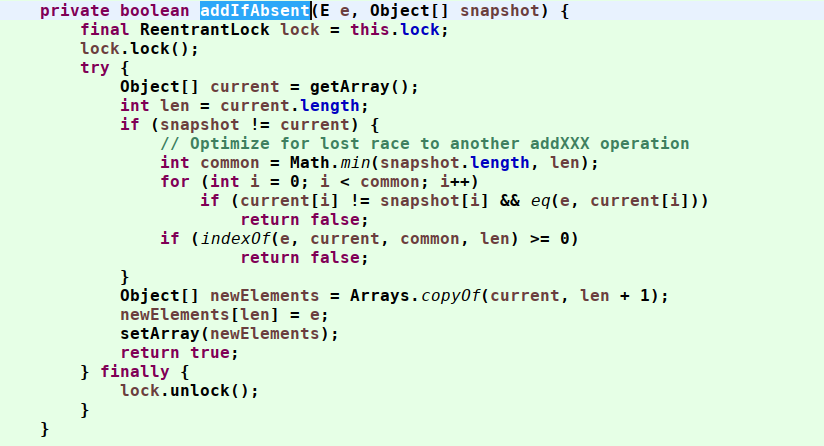
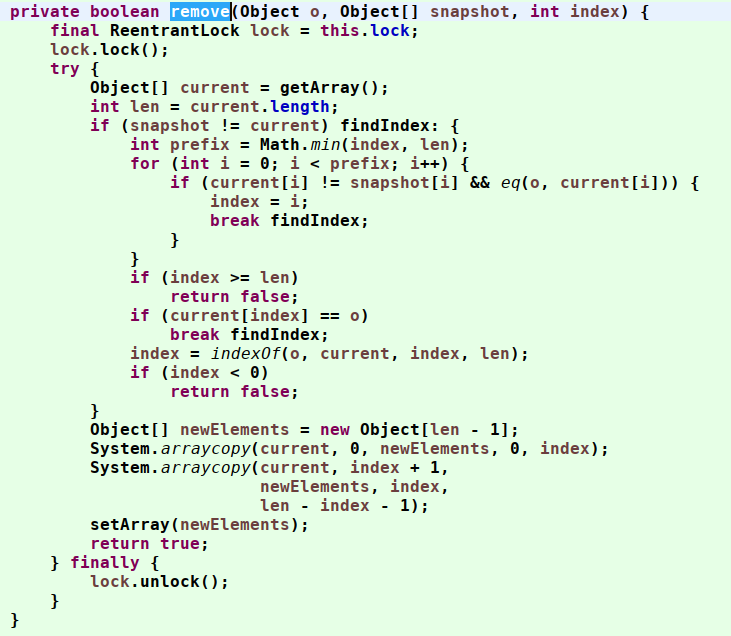
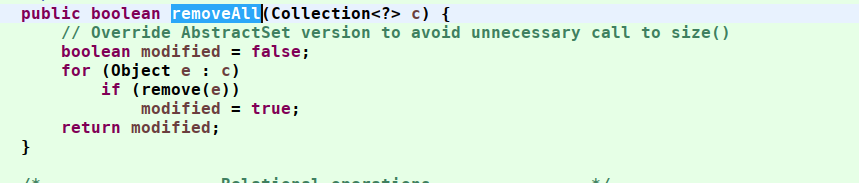
需要注意的是CopyOnWriteArraySet的removeAll和addAll都是线程安全的。
4.ConcurrentSkipListSet
4.1.对比TreeSet
TreeSet内部实现使用的是TreeMap,默认使用key的Comparable实现进行排序
ConcurrentSkipListSet内部实现使用的是ConcurrentSkipListMap,默认使用key的Comparable实现进行排序。
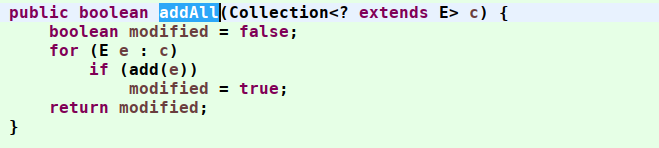
由于ConcurrentSkipListMap内部的现实是没有使用锁的。所以在add和remove操作的时候性能比较好,是并发集合,却不是线程安全的集合。比如进行addAll和removeAll操作的时候是可能被多个线程同时操作的。
5.ConcurrentHashMap
是hashMap的并发容器,内部采用分段锁的方式进行并发操作。每一个段内保存一个Node<K, V>。 写操作的时候只对需要修改的node进行同步锁(synchronized),读的时候会将上锁的node最后读取。
6.ConcurrentSkipListMap
和ConcurrentHashMap相比,ConcurrentSkipListMap性能要差很多,但是ConcurrentSkipListMap是有序的。
7.Queue 和 Deque
7.1.区别
- Queue 是 继承自 Collection 的接口,代表先进先出(FIFO)的数据结构,即元素按照添加的顺序依次被取出。
- Deque 是 Queue 的子接口,全称为双端队列(Double - Ended Queue)。它不仅支持元素的先进先出,还支持在队列的两端进行插入和删除操作, 因此可以当作栈(后进先出,LIFO)或者普通队列(先进先出,FIFO)来使用。
7.2.常见的Queue
阻塞队列的数据结构符合FIFO规则。所以是线程安全的(使用put/take)
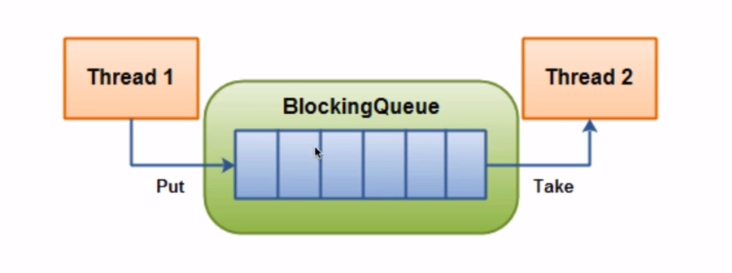
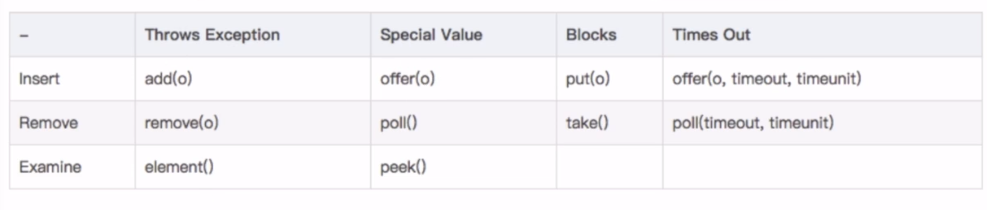
常见的阻塞队列有
- ArrayBlockingQueue,有界的阻塞队列,初始化时制定界限,之后不可修改
- DelayQueue, 会按照线程过期时间进行排序,比如定时关闭连接,缓存对象,请求超时处理等场景。
- LinkedBlockingQueue,可指定界限的阻塞队列
- PriorityBlockingQueue,按照保持对象的Comparable现实进行排序的队列
- SynchronousQueue,只允许存入一个对象的对象
7.3.Queue核心方法
使用建议:他们各自代表了一种数据类型或数据的处理方式,这样能够使我们在处理数据的时候,保证逻辑清楚,效果可预测。
- 直接响应结果,抛出异常:add和remove配合使用
- 直接响应结果,不抛异常:offer和poll配合使用,
- 阻塞等待:put和take配合使用。
1. 插入数据
抛出异常 :add(e)//队列未满时,返回true;队列满则抛出IllegalStateException("Queue full")异常——AbstractQueue
返回值(非阻塞):offer(e)//队列未满时,返回true;队列满时返回false。非阻塞立即返回。
一定时间内返回值:offer(e, time, unit)//设定等待的时间,如果在指定时间内还不能往队列中插入数据则返回false,插入成功返回true。
返回值(阻塞):put(e)//队列未满时,直接插入没有返回值;队列满时会阻塞等待,一直等到队列未满时再插入。

2.获得数据
抛出异常:remove()//队列不为空时,返回队首值并移除;队列为空时抛出NoSuchElementException()异常——AbstractQueue
返回值(非阻塞):poll()//队列不为空时返回队首值并移除;队列为空时返回null。非阻塞立即返回。
一定时间内返回值 :poll(time,unit)//设定等待的时间,如果在指定时间内队列还未孔则返回null,不为空则返回队首值
返回值(阻塞) :take(e)//队列不为空返回队首值并移除;当队列为空时会阻塞等待,一直等到队列不为空时再返回队首值。
7.4.设计一个不会内存溢出的队列
https://github.com/apache/dubbo/pull/9722/files
- 本文作者:zhangxue
- 本文链接:https://lucksnow1989.github.io/article/3.多线程&高并发/4.JUC之二-并发集合.html
- 版权声明:本文为本人原创文章,遵循 CC 4.0 BY-NC-SA版权协议,转载请附上原文出处链接和本声明。