 张雪随笔
消息队列
1.基础
1.1.什么是MQ
消息队列作为高并发系统的核心组件之一,能够帮助业务系统解构提升开发效率和系统稳定性。主要具有以下优势:
- 削峰填谷(主要解决瞬时写压力大于应用服务能力导致消息丢失、系统奔溃等问题)
- 系统解耦(解决不同重要程度、不同能力级别系统之间依赖导致一死全死)
- 提升性能和扩展性(当存在一对多调用时,可以发一条消息给消息系统,让消息系统通知相关系统)
- 蓄流压测(线上有些链路不好压测,可以通过堆积一定量消息再放开来压测)
缺点:
- 增加了系统复杂度。
- 可靠性、稳定性变得很难控制。
1.2.主流MQ协议
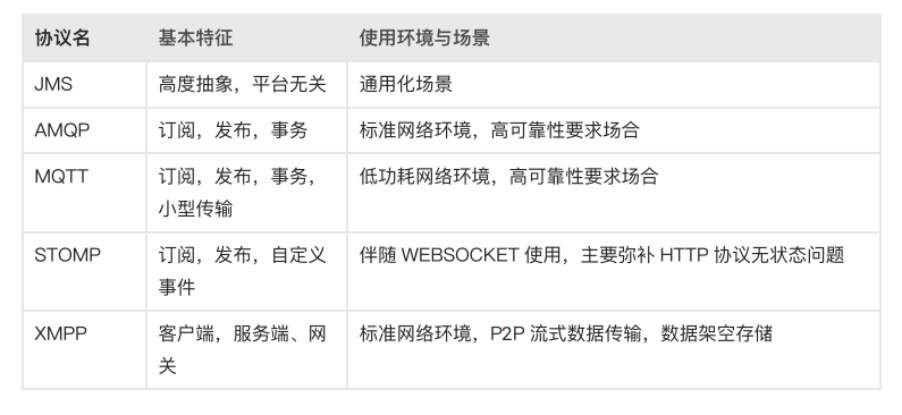
- JMS
- 即Java消息服务(Java Message Service)应用程序接口,不仅仅是一种协议也是是J2EE定义的规范。绝大多数MOM提供商都对JMS提供支持。
- 典型案例:ActiveMQ
- AMQP协议
- AMQP即Advanced Message Queuing Protocol,一个提供统一消息服务的应用层标准高级消息队列协议,是应用层协议的一个开放标准, 为面向消息的中间件设计。基于此协议的客户端与消息中间件可传递消息, 并不受客户端/中间件不同产品,不同开发语言等条件的限制。
- 优点:可靠、通用
- 比较知名的产品有 StormMQ、RabbitMQ、Apache Qpid等
- MQTT协议
- MQTT(Message Queuing Telemetry Transport,消息队列遥测传输)是IBM开发的一个即时通讯协议, 是物联网的重要组成部分。 该协议支持所有平台,几乎可以把所有联网物品和外部连接起来, 被用来当做传感器和致动器(比如通过Twitter让房屋联网)的通信协议。
- 优点:格式简洁、占用带宽小、移动端通信、PUSH、嵌入式系统
- MQTT中文网
- 支持的产品:RocketMQ、RabbitMQ 通过插件支持。
- STOMP协议
- STOMP(Streaming Text Orientated Message Protocol)是流文本定向消息协议, 是一种为MOM(Message Oriented Middleware,面向消息的中间件)设计的简单文本协议。 STOMP提供一个可互操作的连接格式,允许客户端与任意STOMP消息代理(Broker)进行交互。
- 优点:命令模式(非topic\queue模式)
- XMPP协议
- XMPP(可扩展消息处理现场协议,Extensible Messaging and Presence Protocol) 是基于可扩展标记语言(XML)的协议,多用于即时消息(IM)以及在线现场探测。适用于服务器之间的准即时操作。 核心是基于XML流传输,这个协议可能最终允许因特网用户向因特网上的其他任何人发送即时消息,即使其操作系统和浏览器不同。
- 优点:通用公开、兼容性强、可扩展、安全性高,但XML编码格式占用带宽大
- 其他基于TCP/IP自定义的协议
- 有些特殊框架(如:redis、kafka、zeroMq等)根据自身需要未严格遵循MQ规范,而是基于TCP\IP自行封装了一套协议, 通过网络socket接口进行传输,实现了MQ的功能。
2.选型
2.1.比较
| 特性 | ActiveMQ | RabbitMQ | RocketMQ | Kafka |
|---|---|---|---|---|
| producer-comsumer | 支持 | 支持 | 支持 | 支持 |
| publish-subscribe | 支持 | 支持 | 支持 | 支持 |
| request-replay | 支持 | 支持 | 支持 | 支持 |
| 多语言支持 | 支持 | 支持 | 支持 | 支持 |
| 单机高吞吐 | 万级 | 万级 | 十万级 | 百万级 |
| 消息延迟 | 微秒级 | 毫秒级 | 毫秒级 | |
| 可用性 | 高(主从) | 高(主从) | 非常高(分布式) | 非常高(分布式) |
| 消息丢失 | 低 | 低 | 理论上不丢失数据 | 理论上不丢失数据 |
| 消息重复 | 会重复 | 可控制 | 会重复 | 会重复 |
| api完整性 | 高 | 高 | 高 | 高 |
| 文档完整性 | 高 | 高 | 高 | 高 |
| 提供快速入门 | 有 | 有 | 有 | 有 |
| 首次部署难度 | 低 | 低 | 低 | 中 |
| 部署方式 | 独立或者嵌入式 | 独立 | 独立 | 独立 |
| 社区活跃度 | 低 | 高 | 中 | 高 |
| 商业支持 | 无 | 无 | 阿里云 | 无 |
| 成熟度 | 成熟 | 成熟 | 成熟 | 成熟(日志领域) |
| 协议 | AMQP,REST,XMPP | AMQP | 自定义 | 无 |
| 持久化 | 内存、文件、数据库 可选 | 内存、文件 | 文件 | 文件 |
| 消息事务 | 支持 | 支持 | 支持 | 不支持 |
| 负载均衡 | 支持 | 支持 | 支持 | 支持 |
| 管理界面 | 一般 | 好 | 好 | 不好 |
- ActiveMQ
- 优点:产品成熟、使用广泛、跨语言客户端多、文档丰富、协议支持的多
- 缺点:高吞吐下,堆积消息容易Hang住;某些不稳定的环境容易丢失数据;无法支持大规模多队列的场景。
- RabbitMQ
- 优点:erlang的特性就是高性能。可视化界面支持的好,支持中文,可搭建大规模集群
- 缺点:不好扩展,集群不支持动态扩展。是管子不是池子。RabbitMQ对消息堆积的支持并不好,当大量消息积压的时候,会导致 RabbitMQ 的性能急剧下降
- RocketMQ
- 优点:接口易用,架构简单,易扩展。支持的特性多。社区活跃,使用Java开发易扩展。淘宝使用50台服务器搭建集群,实现日处理百亿消息。
- 缺点:内部实现的协议,客户端只支持Java/C/GO。
- Kafka
- 优点:性能最好的mq,大量使用在大数据领域。
- 缺点:不适合大规模集群,功能单一,需要用户进行二次封装。
2.2.选型原则
根据场景选型,比如
- 金融场景适合 RocketMQ,可实现公司级超大规模集群
- 大数据应用场景,适合 kafka。重点在于日志传输,以及消息总线
- OA办公软件,适合 ActiveMQ,功能多,文档丰富。
3.处理语义
3.1.工作流程可能存在的问题
- 发送消息:消息已经在broker上已经接收到(甚至已经完成持久化),由于网络闪断、客户端宕机等问题,导致服务端对客户端应答失败, 如果此时生产者意识到消息发送失败并尝试再次发送消息。
- 消费消息:消息已投递到消费者并完成业务处理,当客户端给服务端反馈应答的时候网络闪断。
- reblance:包括但不限于网络抖动、Broker或客户端重启、扩容或缩容时
出现上面问题时,可能出现以下问题:而大多数情况下,都需要我们应用程序自己实现幂等性;通过数据库实现消息的最终一致性。
- 消息丢失
- 消息重复
3.2.语义
流处理(streaming process),也称为事件处理(event processing),是对于一个无限的数据或事件序列的连续处理。 一个流,或事件,处理应用可以或多或少地由一个有向图,通常是一个有向无环图(DAG),来表达。 在图中,每条边表示一个数据或事件流,而每个顶点表示使用应用定义好的逻辑来处理来自相邻边的数据或事件的算子。 其中有两种特殊的顶点,Sources消费外部数据/事件并将其注入到应用当中,sinks通常收集由应用产生的结果。
一个流/事件的处理引擎通常允许用户制定一个可靠性模式或者处理语义,来标示引擎会为应用图的实体之间的数据处理提供什么样的保证。 由于你总是会遇到网络、机器这些会导致数据丢失的故障,因而这些保证是有意义的。 有三种模型/标签,at-most-once、at-least-once以及exactly-once,通常被用来描述流处理引擎应该为应用提供的数据处理语义。
- At-most-once。所有的算子最多执行一次,其实就是尽力而为。
- At-least-once。所有算子都至少处理一次,直到结果证明没有必要的第二次执行为止。
- Exactly Once。即消息肯定会被成功消费,并且只会被消费一次
4.高可用
MQ宕机就直接导致你的系统本身也故障了,然后可能会导致你的公司对外的APP、网站等产品就无法运作了,用户无法使用你们公司的服务了。 如果你们公司是电商平台、外卖平台、社交平台。那么来这么一出,不是会导致公司损失惨重? 如果你的系统持续几个小时无法被人使用, 本来你公司电商平台一天营收可以达到1亿,结果现在导致几个小时内无法下单购买商品,最后当天营收就5000万,那么你的公司是不是直接活生生损失了5000万?
高可用方案:
- 集群化部署架构以及数据多副本冗余机制,是非常常见的一种高可用架构。例如kafka。
- 多副本同步复制强制要求。让生产者通过一些参数的设置,保证消息写到某台机器后,必须同步到另外一台机器成功,集群里有双副本了, 然后此时才可以认为这条消息写成功了。 但凡刚写一台机器他就宕机,还没来得及复制到另外一台机器的话,本次写应该报错失败, 然后你应该重试再次写入数据到MQ集群里去。例如rocketmq可以设置同步策略,kafka 可以设置acks。
- 多机器承载多副本强制要求。多节点同步,设置成功数量达到阈值就算成功,比如kafka 可以设置,同步成功的数量。
5.mq
5.1.rocketmq
5.2.kafka
5.3.rabbitmq
- 官网:https://www.rabbitmq.com/
- 工作原理:https://blog.csdn.net/gzyx1988/article/details/124243530
- 安装:https://blog.csdn.net/m0_67392182/article/details/126040124
- 基础使用:https://blog.csdn.net/GSZTK/article/details/127630713
kafka和rocketmq都是采用的自定义协议,而rabbitmq支持AMQP/MQTT/HTTP等多种协议。
exchange功能强大:消费模型支持直连(Direct)、主题(Topic)、扇出(fanout)、头匹配(headers)等路由策略,可以组合实现复杂的路由规则。
低延迟和时效性,微秒级延迟:可以选择不持久化到磁盘到达微秒级延迟,适合对实时性要求很高的场景,例如游戏指令等。
优点:
- 轻量级部署:单节点资源占用低(内存100MB即可部署),适合中小规模应用或者边缘计算场景。
- 丰富的功能:内置vHost多租户、消息确认机制ACK、死信DLX、TTL、优先级队列、confirm/return、流控背压等
- 提供完整功能的控制面板:方便队列控制状态、消息堆积等。kafka和rocketmq为的是云服务,开源的不行。
- 事务消息。使用txSelect、txCommit实现事务消息。
- 社区成熟度。支持Java、Python、go、Ruby等有很多优质客户端。社区成熟度高,文档丰富。
缺点:高吞吐、海量堆积等场景不行。架构设计原因
- 高可用。早期本使用镜像模式,主节点写入数据阻塞的同步到镜像节点。
- 集群镜像节点不参与消费,只有副本没有分区,压力全在主节点。消息堆积超过百万,性能就会极具下降。
rabbitmq 4.x优化了什么?
- 引入仲裁队列,是一种全新的队列类型,强数据一致性。数据存储分片到多个节点,使用raft在达成共识和选举 读写压力分配到所有节点,提升整体性能。同时集群可用性也提升了,相对的,rabbit的延迟也高了。
- streams消息。支持高吞吐量的数据传输。内部采用基于日志的结构,适用于实时数据分析、事件驱动、物联网等场景。 但是streams并不支持强一致性,采用"至少一次交付 at least once delivery"语言,可能重复消费。
5.4.activemq
官网:http://activemq.apache.org
解压即可启动
运行bin/win64/activemq.bat即可
ActiveMQ 服务启动地址:http://127.0.0.1:8161/admin/
用户名/密码 admin/admin
修改密码在conf/users.properties 和 conf/group.properties
5.4.1.什么是JMS
JMS即Java消息服务(Java Message Service)应用程序接口,是一个Java平台中关于面向消息中间件(MOM)的API, 用于在两个应用程序之间, 或分布式系统中发送消息,进行异步通信。Java消息服务是一个与具体平台无关的API, 绝大多数MOM提供商都对JMS提供支持。
5.4.2.JMS体系架构
JMS提供者(provider):连接面向消息中间件的,JMS接口的一个实现。 提供者可以是Java平台的JMS实现,也可以是非Java平台的面向消息中间件的适配器。
- JMS客户:生产或消费基于消息的Java的应用程序或对象。
- JMS生产者(producer):创建并发送消息的JMS客户。
- JMS消费者(consumer): 接收消息的JMS客户。
- JMS消息(message):包括可以在JMS客户之间传递的数据的对象
- JMS队列(queue):一个容纳那些被发送的等待阅读的消息的区域。与队列名字所暗示的意思不同,消息的接受顺序并不一定要与消息的发送顺序相同。一旦一个消息被阅读,该消息将被从队列中移走。
- JMS主题(topic):一种支持发送消息给多个订阅者的机制。
5.4.3.对象模型
- 连接工厂。连接工厂(ConnectionFactory)是由管理员创建,并绑定到JNDI树中。客户端使用JNDI查找连接工厂,然后利用连接工厂创建一个JMS连接。
- JMS连接。JMS连接(Connection)表示JMS客户端和服务器端之间的一个活动的连接,是由客户端通过调用连接工厂的方法建立的。
- JMS会话。JMS会话(Session)表示JMS客户与JMS服务器之间的会话状态。JMS会话建立在JMS连接上,表示客户与服务器之间的一个会话线程。
- JMS目的。JMS目的(Destination),又称为消息队列,是实际的消息源。
- JMS生产者和消费者。生产者(Message Producer)和消费者(Message Consumer)对象由Session对象创建,用于发送和接收消息。
- JMS消息通常有两种类型:
- 点对点(Point-to-Point):消费者只能主动去获得消息或注册监听器获得消息。在点对点的消息系统中,消息分发给一个单独的使用者。 点对点消息往往与队列(javax.jms.Queue)相关联。
- 发布/订阅(Publish/Subscribe): 发布/订阅消息系统支持一个事件驱动模型,消息生产者和消费者都参与消息的传递。 生产者发布事件,而使用者订阅感兴趣的事件,并使用事件。该类型消息一般与特定的主题(javax.jms.Topic)关联。
5.4.4.消息类型
JMS定义了五种不同的消息正文格式,以及调用的消息类型,允许你发送并接收以一些不同形式的数据,提供现有消息格式的一些级别的兼容性。
- StreamMessage: Java原始值的数据流
- MapMessage:一套键值对
- TextMessage:一个字符串对象(最常用)
- ObjectMessage:一个序列化的 Java对象
- BytesMessage:一个未解释字节的数据流
5.5.pulsar
Apache 推荐使用的MQ。但是pulsar的性能、稳定性、成熟度、社区活跃度都不如上面几个。
5.6.AutoMQ
开源地址:https://github.com/AutoMQ/automq
腾讯音乐如何基于 AutoMQ 降低 Kafka 50%+ 成本:https://mp.weixin.qq.com/s/EOVIMw_2JXEdrJlbAf8HUw
AutoMQ是由Apache RocketMQ和Linux LVS核心创始团队创立的云原生消息队列服务商,致力于通过云端架构实现流存储和消息处理的十倍降本增效。
- 核心能力:基于S3对象存储重构Apache Kafka,实现存算分离架构,兼容Kafka协议、提供自动弹性伸。
- 核心价值:通过云原生技术改造,相比传统Kafka降低80%云资源成本,并提供同城3AZ容灾能力
- 本文作者:zhangxue
- 本文链接:https://lucksnow1989.github.io/article/8.微服务/4.消息队列/消息队列.html
- 版权声明:本文为本人原创文章,遵循 CC 4.0 BY-NC-SA版权协议,转载请附上原文出处链接和本声明。