 张雪随笔
9.向量数据库
Milvus
- 可视化界面:https://github.com/zilliztech/attu
-
[milvus(一) milvus是什么](https://mp.weixin.qq.com/s/gdowlcSWOHjKcizhuNNtHA) -
[milvus(二) 单机Standalone安装](https://mp.weixin.qq.com/s/LI3cDZNOU4uB5O4RqFwY9w) -
[milvus(三) 使用](https://mp.weixin.qq.com/s/3v5R-2iv7eZRPIHfA51Qlw)
1.介绍
Milvus 是一个为 GenAI 应用程序构建的开源向量数据库。专为处理大规模向量数据设计,并在性能损失最小的情况下扩展到数十亿个向量。 它主要用于存储、索引和管理由深度神经网络和其他机器学习模型生成的嵌入向量,适用于图像、视频、音频和文本等非结构化数据的特征表示。
Milvus中采用二维的表结构维护数据,核心概念
- collections。存储向量及其相关元数据,类似传统数据库中的表。
- schema。相当于collections的数据结构,包括字段、类型等。
- index。索引,单独对collections设置,跟schema没有关系。
分布式一致性采用 Paxos 算法的变种 来保证元数据的一致性,同时结合 Raft 协议 实现数据分片的分布式共识
- Root Coord:全局元数据管理,使用 Multi-Paxos 保证元数据变更的一致性。
- Data Coord:数据分片(Segment)的生命周期管理,基于 Raft 协议 维护分片状态。
- Query Coord:查询调度与负载均衡,依赖 Raft 协议 同步查询计划。
-
Index Coord:索引构建管理,通过 Raft 协议 协调索引任务。
- 采用 Multi-Paxos 确保元数据的强一致性。Root Coord 是集群的核心共识组件,负责维护全局元数据(如集合、分区、索引的元信息)。
- 采用 Raft实现数据副本的一致性。
- 数据分片管理:Data Node 之间通过 Raft 协议维护 Segment 的多副本一致性。
- 查询计划同步:Query Node 基于 Raft 协议同步查询计划,确保查询结果的一致性。
- 简化选举机制:Raft 通过心跳机制和随机超时时间快速选举领导者,减少脑裂风险。
2.使用案例
from pymilvus import MilvusClient, DataType, model

# pip install -U pymilvus
client = MilvusClient(
    uri="http://192.168.3.99:19530",
    token="root:Milvus",
    db_name="default"
)

# Schema 定义了 Collections 的数据结构,不使用自增id
schema = MilvusClient.create_schema(auto_id=False, enable_dynamic_field=True)

# 向Schema添加字段:my_id 主键id, int64,my_vector 向量类型, my_varchar 向量的明文
schema.add_field(field_name="my_id", datatype=DataType.INT64, is_primary=True)
schema.add_field(field_name="my_vector", datatype=DataType.FLOAT_VECTOR, dim=768)  # 向量维度768
schema.add_field(field_name="my_varchar", datatype=DataType.VARCHAR, max_length=512)

# 开始创建索引
index_params = client.prepare_index_params()

# 添加索引: my_id 为 主键索引。 my_vector 设置向量的计算方式为:COSINE 余弦相似度
index_params.add_index(field_name="my_id", index_type="STL_SORT")
index_params.add_index(field_name="my_vector", index_type="AUTOINDEX", metric_type="COSINE")

# 创建collection
if client.has_collection("customized_demo"):
    client.drop_collection(collection_name="customized_demo")

client.create_collection(
    collection_name="customized_demo",
    schema=schema,
    index_params=index_params,
)

client.describe_collection("customized_demo")
res = client.describe_collection("customized_demo")
print("数据结构", res)

# 加载默认Embedding模型:需要安装pip install "pymilvus[model]"
embedding_fn = model.DefaultEmbeddingFunction()

# 定义一个文本的列表
docs = [
    "Artificial intelligence was founded as an academic discipline in 1956.",
    "Alan Turing was the first person to conduct substantial research in AI.",
    "Born in Maida Vale, London, Turing was raised in southern England.",
]

# 把文本编码为Embedding
vectors = embedding_fn.encode_documents(docs)
print("嵌入后的向量维度:", embedding_fn.dim, vectors[0].shape)  # 维度数量: 768 (768,)

# 生成需要插入的数据格式
data = [
    {"my_id": i, "my_vector": vectors[i], "my_varchar": docs[i]}
    for i in range(len(vectors))
]
print("数据 :", len(data), "条, 所有字段: ", data[0].keys())
print("向量维度:", len(data[0]["my_vector"]))

# 输出:
# 嵌入后的向量维度: 768 (768,)
# 数据 :3 条, 所有字段:  dict_keys(['id', 'vector', 'text', 'subject'])
# 向量维度: 768

res = client.insert(
    collection_name="customized_demo",
    data=data
)
print("插入数据结果:", res)
# 插入数据结果: {'insert_count': 3, 'ids': [0, 1, 2]}

res = client.get_load_state(
    collection_name="customized_demo",
)
print(res)

# 将查询文本转为embedding
query_vectors = embedding_fn.encode_queries(["Alan Turing"])
print("查询向量维度:", len(query_vectors[0]))

res = client.search(
    collection_name="customized_demo",  # 目标 collection
    data=query_vectors,  # 查询文本的向量
    limit=2,  # 返回的实体数
    output_fields=["my_id", "my_vector", "my_varchar"],  # 指定返回的字段
)
print("search结果:", res)
'''
search结果:data: [
    "[
        {'id': 2, 'distance': 0.5859944820404053, 'entity': {'id': 2, 'text': 'Born in Maida Vale, London, Turing was raised in southern England.', 'subject': 'history'}},
        {'id': 1, 'distance': 0.5118255019187927, 'entity': {'id': 1, 'text': 'Alan Turing was the first person to conduct substantial research in AI.', 'subject': 'history'}}
    ]"
]
'''
3.相似度搜索算法-索引类型
3.1.索引类型
Milvus 通过索引类型 指定 向量字段的近似近邻搜索算法。通过优化索引的类型,实现索引加速搜索。 通过丰富的算法库支持不同场景下的向量检索需求,从精确匹配到近似匹配,从高召回率到极致压缩。 实际应用中,需根据数据规模、查询性能、内存限制和精度要求选择合适的算法,并通过调优参数进一步平衡性能和召回率。
https://milvus.io/docs/zh/index-explained.md
索引类型由三个核心部分组成,即数据结构、量化和精炼器。量化和精炼器是可选的,但由于收益大于成本的显著平衡而被广泛使用。
- 数据结构:
- IVF(倒排文件索引):也就是粗筛
- 实现原理:将空间划分为多个单元,以单位的中心点表示这个单元。查询时先找到距离中心点最近的K个单元,然后再向单元内搜索相似向量。也就是预先计算。
- IVF_FLAT:单元内存储原始向量。
- IVF_SQ8:单元内存储向量的 8 位量化表示,节省空间但牺牲部分精度。
- 适用场景:适合需要快速吞吐量的大规模数据集。
- HNSW(基于图):也就是精筛
- 实现原理:构建多层图结构,底层包含所有向量,高层是稀疏连接的导航层。查询时从高层开始快速定位到近似区域,再逐层下降到低层进行精细搜索。
- 适用场景:适用于高维空间和要求低延迟查询的场景。
- IVF(倒排文件索引):也就是粗筛
- 量化:量化通过更粗略的表示来减少内存占用和计算成本:
- 标量量化(IVF_SQ8)将每个向量维度压缩为单字节(8 位),与 32 位浮点数相比,内存使用量减少了 75%,同时保持了合理的精度。
- 乘积量化(IVF_PQ)将向量分割成子向量,并使用基于编码本的聚类进行编码。这可以实现更高的压缩率(例如 4-32 倍),但代价是召回率略有降低,因此适用于内存受限的环境。
- 精炼器:量化本身就是有损的。为了保持召回率,量化始终会产生比所需数量更多的前 K 个候选结果,这使得精炼器可以使用更高的精度从这些候选结果中进一步选择前 K 个结果,从而提高召回率。
性能权衡:从构建时间、每秒查询次数(QPS)和召回率等三个方面进行评估:
- 就QPS 而言,基于图形的索引类型通常优于IVF 变体。
- IVF 变体尤其适用于topK 较大的情况(例如,超过 2,000 个)。
- 与SQ相比,PQ通常能在相似的压缩率下提供更好的召回率,但后者的性能更快。
- 将硬盘用于部分索引(如DiskANN)有助于管理大型数据集,但也会带来潜在的 IOPS 瓶颈。
除此之外,还有其他的索引
- 向量索引:
- FLAT (强制索引),全表参与计算进行搜索,只有在collection数据量很低时可以使用。
- GPU索引:以上的索引都提供了GPU的计算支持。
- 标量索引:非向量使用,例如STL_SORT、INVERTED(倒排索引)等
3.2.适用场景索引推荐
| 索引类型 | 适用场景 | 优势 | RAG 场景适配建议 |
|---|---|---|---|
| HNSW | 高维向量(100-1000 维)、中等数据规模 | 检索速度极快(毫秒级)、精度高 | 适用于实时问答、短文本检索(如对话历史匹配) |
| IVF_FLAT | 大规模数据(百万级以上)、召回率优先 | 存储效率高、支持动态数据插入 | 适用于文档库检索(如知识库、长文本分段存储) |
| IVF_SQ8 | 超大规模数据、存储成本敏感 | 量化压缩向量(8bit 存储),节省空间 | 适用于冷数据存储或低成本部署 |
| PQ | 超大规模数据、近似检索可接受 | 乘积量化压缩,极致空间效率 | 非核心场景的兜底方案(慎用,可能影响精度) |
3.3.最佳实践
HNSW系列:https://milvus.io/docs/zh/hnsw.md
- M(图中每个节点的最大连接数):包括出边和入边。该参数直接影响索引构建和搜索。
- 范围:8~200,默认 16
- 影响:M 越大,图结构越复杂,检索精度越高,但构建速度和内存占用增加。
- RAG 建议:对话场景取 M=32~64(兼顾速度与精度),文档检索可取 M=64~128(高精度优先)。
- efConstruction(构建时的邻居数):
- 范围:100~400,默认 100
- 影响:控制索引构建质量,值越大索引更准确,但构建时间延长。
- RAG 建议:与 M 成比例(如 M=64 时 efConstruction=200~300)。
IVF系列:https://milvus.io/docs/zh/ivf-flat.md
- nlist(聚类簇数):建立索引时生成的簇数。每个簇由一个中心点代表,存储一个向量列表。增大可提升查询速度,但会增加索引构建时间。
- 经验公式:nlist ≈ 数据量^(0.5~0.7)(如 100 万数据取 nlist=1024,1 亿数据取 nlist=8192)
- 注意:nlist 过大会增加内存消耗,建议通过
utility.calculate_best_nlist自动计算。
- nprobe(查询时探测的簇数):数值越大,搜索的簇数越多,搜索范围越大,召回率越高,但代价是查询延迟增加。
- 查询参数,非索引参数!取值范围:1~nlist
- 影响:nprobe 越大,检索精度越高(接近暴力搜索),但延迟增加。
- RAG 最佳实践:设置为 nlist 的 1~5%(如 nlist=4096 时 nprobe=32~64)。
索引创建示例
from pymilvus import IndexType, MetricType

# 创建 HNSW 索引(适合 768/1536 维的嵌入向量)
collection.create_index(
    field_name="vector",
    index_params={
        "index_type": IndexType.HNSW,
        "metric_type": MetricType.L2,  # 或 IP 用于余弦相似度
        "params": {"M": 64, "efConstruction": 200}  # 基础参数
    }
)

# 创建 IVF_FLAT 索引(适合亿级数据)
collection.create_index(
    field_name="vector",
    index_params={
        "index_type": IndexType.IVF_FLAT,
        "metric_type": MetricType.L2,
        "params": {"nlist": 4096}  # 聚类中心数,通常为 2^12~2^15
    }
)
4.相似度计算-距离计算算法
通过度量实现向量之间相似的计算,选择合适的度量有助于提升分类和聚类性能。 https://milvus.io/docs/zh/metric.md
- L2:欧氏距离,计算向量空间中两点的直线距离,衡量绝对差异。L2越小,特征越相似(如用户行为特征聚类)。
- 适用场景:数值型稠密数据,如图像特征(CNN 输出的 embedding)、传感器数据(像素值、坐标点),需关注数值绝对差异。
- IP:内积,衡量向量在方向上的相关性,同时受向量长度影响。向量越长,内积值越大;若向量已归一化,等价于 Cosine 相似度。
- 适用场景:推荐系统中用户-物品
- COSINE:余弦相似度,衡量向量夹角余弦值,忽略长度,仅关注方向相似性。夹角越小,越相似。
- 高维稀疏数据:如文本(TF-IDF、BERT 向量)、基因序列等,向量长度常由特征数量决定,方向更关键。
- 语义 / 风格匹配:自然语言处理(NLP)中的句子相似性、图像风格检索(如 CNN 特征归一化后)。
- 推荐系统(归一化向量):用户 / 物品 embedding 经归一化后,Cosine 更稳定(如 YouTube 推荐架构)。
- HAMMING:汉明距离,适用于二进制向量(如哈希编码)
- JACCARD:杰卡德相似度,适用于集合相似度(如文档相似度),只能应用于有限样本集。
- BM25:专门用于稀疏向量的全文检索
最佳实践
- 若向量含义侧重 "方向"(如文本语义匹配),需先归一化,再用 Cosine/IP。
- 若向量包含 "绝对数值" 信息(如图像像素/视觉特征检索):L2。
- 推荐系统(未归一化 embedding):IP
- Milvus 中 IVF 类索引(如 IVF-Flat、IVF-SQ8)对 L2 和 Cosine 支持更优,IP 需确保向量归一化后使用。
以下重点为余弦相似度:
余弦相似度:余弦相似度是向量之间角度的余弦值,它是向量的点积除以它们长度的乘积。
公式:两个向量A和B的余弦相似度= AB / |A||B|。
- 向量的长度通常是欧几里得范数(L2范数) ```python def calc_cos_sim(a, b): """ 计算两个特征向量的点积,然后除以两个向量的范数乘积。 结果是两个向量的余弦相似度,范围在[-1, 1]之间,值越大表示两个向量越相似。-1为完全不相似,1为完全相似。 """ return np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b))
假设A=(1,2,3), B=(4,5,6),这里使用3个维度计算,实际中向量维度可达1024。
- AB点积=14 + 25 + 3*6=4+10+18=32
- 计算长度乘积:(1^2 + 2^2 + 3^2)开方 = 14的开方,(4^2 + 5^2 + 6^2)开方 = 77的开方 余弦相似度:32 / (14 * 77)开方=0.9746。 ```
5.高性能集群搭建
AI爆火的时候,技术架构搭建的时候图简单,就选了一些门槛足够低的入门级数据库,结果等到产品落地、数据量飞涨的时候,用户几天之内从五千涨到十万,服务器崩完,数据库崩,扩容了一礼拜。
由于不同用户的业务模式不同,因此每个用户都需要在底层向量检索引擎中拥有独立的 collection,用于隔离业务数据,自定义数据模型,以及适配不同的 embedding 模型 大多用户的数据体量并不大,而且业务的繁忙时段不同,因此,多租户共用一个集群,一个 collection 一个租户的方案无疑非常适合这个场景。
然而,这个模式随着业务的扩展和客户量的快速增长遇到了问题,尤其是当租户数量攀升至万级以上时,单集群内支持大规模 collection 管理就成了系统性能与运维的最大瓶颈: 传统的元数据、RPC 调度和资源分配机制在如此规模下难以承受,查询与加载延迟也会显著提高。
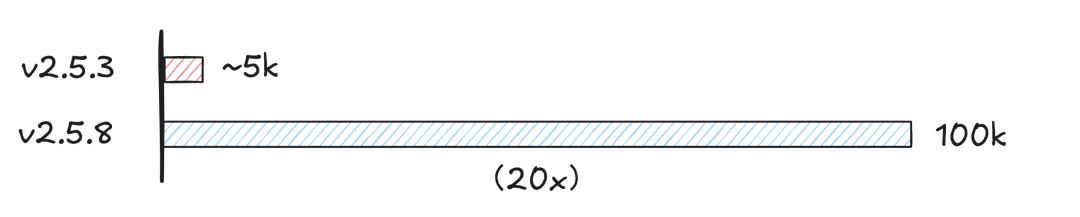
Milvus 从 v2.5.3 起陆续引入了包括容量上限提升、调度策略优化、内存管理改进等多项核心优化;到 v2.5.8 版本,我们将单集群支持的 collection 数量从数千扩展至十万级。
性能问题
- 后台索引构建任务堆积。Milvus 采用shared和分区实现高可用和高性能。其物理存储采用segment存储数据(默认2GB)。 Milvus 后台会针对每个 segment 触发多个索引构建任务。在超大规模 collection 集群中,随着数据的持续写入, segment 数量会达到百万级(例如,若系统中有 10k 个 collection,每个 collection 有 100 个 partition,则 segment 数量至少会有 10k * 100 个), 因而使得系统触发的索引构建任务会达到数百万个,导致任务积压率持续升高,查询性能衰减,任务调度成为系统瓶颈点之一。
- 操作延迟急剧上升:向量搜索是非常消费计算资源的,collection 数量突破 5k 后,关键操作的延迟显著上升,创建 collection 操作从百毫秒上升至几秒, 批量插入延迟从几十毫秒上升至几秒,并且操作的延迟还会随着 collection 数量的增加而不断上升,严重影响系统可用性。
- 重启恢复慢:百万级 segment 会使得系统的 kv 元数据量达到数百万,系统冷启动或者故障恢复时需 30+ 分钟才能完成元数据加载,加上消息流订阅及数据加载等,系统完整恢复需要耗时几小时以上,严重制约系统的故障恢复速度和可用性。
架构设计优化:
- 扩展集群节点。milvus的架构设计采用DataNode和QueryNode实现读写分离。 我们可以横向扩展 QueryNode、DataNode 数量,利用并行计算提升吞吐量。同时DataNode和QueryNode分别部署在不同的节点,方式混合使用相互影响性能。
- 冷热数据分离。【定期删除过期文档 或 使用TTL(自动删除)】
- 高频数据(近期数据)存储在 SSD 或内存中,使用 HNSW 等高召回率索引。
- 低频数据(历史数据)迁移至 HDD,使用 IVF_PQ 等压缩索引节省空间。
- 缓存策略
- 一级缓存。提前开发部分数据的mmap,加速查询效率。
- 二级缓存。将高频访问数据,加载但本地缓存中,采用本地内存向量存储,实现压力分散。
- 硬件优化。
- GPU 加速:部署 Milvus 时启用 GPU(需安装
pymilvus-gpu版本),加速 HNSW 索引构建和查询(尤其适合高维数据)。 - 内存分配:确保 Milvus 服务内存足够容纳索引数据(HNSW 索引需将图结构加载到内存,建议单节点内存为数据量的 10~20%)。
- GPU 加速:部署 Milvus 时启用 GPU(需安装
查询性能优化
- 选择合适的索引策略。考虑是否使用量化。
- 千万级选择:HNSW。参数调优建议:M=16~64, efConstruction=200~500
- 亿级以上选择:IVF_PQ。参数调优建议:nlist=4096~32768, m=8~64
- 选择合适的相似度计算算法。
- 数据分区。建议按照业务维度拆分。
- 时间分区:按文档/对话的创建时间(如
month=2025-05),适合处理时序数据(如日志、聊天记录)。 - 类别分区:按文档类型(如
type=faq/type=policy)或用户 ID 分区,缩小检索范围。 - 哈希分区:对高基数字段(如用户 ID)做哈希分片,均匀分布数据。
- 时间分区:按文档/对话的创建时间(如
- 查询条件优化。
- efSearch(HNSW 索引):控制查询时的搜索宽度,增大可提升召回率但降低速度。
- topk:减少单次查询返回的结果数,避免大量数据传输。
- nprobe(IVF 索引):根据数据规模调整,通常为 nlist 的 1-5%。
- 过滤条件优化。过滤条件与向量检索结合。在
search中添加 SQL 风格的过滤条件,先通过元数据过滤无效数据,再做向量检索。
- 本文作者:zhangxue
- 本文链接:https://lucksnow1989.github.io/article/21.机器学习/2.大模型基础/9.向量数据库.html
- 版权声明:本文为本人原创文章,遵循 CC 4.0 BY-NC-SA版权协议,转载请附上原文出处链接和本声明。