 张雪随笔
2.持久化&连接池
1.持久化
持久层框架,也称为ORM框架
- Object 对象
- Relational 关系型数据库
- Mapping 映射
常见ORM技术:
- jdbc:jdk提出的规范,各个厂商去实现各自的数据库驱动,所有的orm框架都是对jdbc不同程序的封装
- MyBatis:优秀的持久层框架,它支持定制化 SQL、存储过程以及高级映射
- Mybatis-Plus:国产 MyBatis 增强工具,简化开发、提高效率
- Spring Jdbc Template:spring 对 jdbc的简单封装
- JPA:Java Persistent API,oracle官方规定的持久层规范,在开发中可能使用到的还有,hibernate就会jpa最好的一个实现方案。
- spring data jpa:spring对jpa的实现方案
- Hibernate:完全的面向对象的orm框架
- DbUtils:只是对JDBC简单封装,不支持事务
1.1.jdbc
JDBC API 是一个 JDK 提出的规范,它可以访问任何类型的表格数据,特别是可以访问存储在关系数据库里的数据。 需要各个数据库的厂商按照jdk的接口实现对应的客户端。
JDBC驱动程序共分四种类型:
-
JDBC-ODBC桥:开放数据库连接(Open Database Connectivity,ODBC)是为解决异构数据库间的数据共享而产生的,也是一种标准。 这种类型的驱动把所有JDBC的调用传递给ODBC,再让后者调用数据库本地驱动代码。
-
本地API驱动:这种类型的驱动通过客户端加载数据库厂商提供的本地代码库(C/C++等)来访问数据库,而在驱动程序中则包含了Java代码。
-
网络协议驱动:这种类型的驱动给客户端提供了一个网络API,客户端上的JDBC驱动程序使用套接字(Socket)来调用服务器上的中间件程序,后者在将其请求转化为所需的具体API调用。
-
本地协议驱动:这种类型的驱动使用Socket,直接在客户端和数据库间通信。一个纯粹的基于 Java 的驱动程序通过 socket 连接与供应商的数据库进行通信。是性能最高的驱动程序,并且通常由供应商自身提供。 这种驱动器是非常灵活的,你不需要在客户端或服务端上安装特殊的软件。比如MySQL Connector/J。
第四种是目前的主流驱动,通过加载一个 jar 包来达到连接数据库目的的。
JDBC 的 SPI 机制:SPI(Service Provider Interface)是 Java 提供的一种服务发现机制,它允许第三方服务提供者通过在特定目录下配置文件的方式,将自己的服务实现注册到 Java 程序中。 在 JDBC 里,SPI 机制用于发现和加载不同数据库的驱动程序,使得 Java 应用程序可以在不修改代码的情况下,方便地切换不同的数据库。
1.2.DbUtils
教程:https://blog.csdn.net/u013628152/article/details/42126547
commons-dbutils 是 Apache 组织提供的一个开源 JDBC工具类库,它是对JDBC的简单封装,学习成本极低。
1.3.jpa
教程:
JPA(Java Persistence API)是Sun官方提出的JavaEE持久化规范。 它为Java开发人员提供了一种对象/关联映射工具来管理Java应用中的关系数据。
他的出现主要是为了简化现有的持久化开发工作和整合ORM技术,结束现在Hibernate,TopLink,JDO等ORM框架各自为营的局面。
值得注意的是,JPA是在充分吸收了现有Hibernate,TopLink,JDO等ORM框架的基础上发展而来的,具有易于使用,伸缩性强等优点。
从目前的开发社区的反应上看,JPA受到了极大的支持和赞扬,其中就包括了Spring与EJB3.0的开发团队。
注意:JPA是一套规范,不是一套产品,那么像Hibernate,TopLink,JDO他们是一套产品,如果说这些产品实现了这个JPA规范, 那么我们就可以叫他们为JPA的实现产品。
1.4.hibernate
JDBC依赖于SQL,属于结构化语言,是一种不完全的面向对象的方式,而hibernate能做到完全面向对象的方式操作数据库,实现了JavaEE的规范JPA
优点
- 部分场景比较简单;
- 数据缓存:一级缓存 二级缓存 查询缓存;
- 移植性比较好,与数据库无关。
缺点
- 因为sql语句是hibernate内部生成的,所以程序员干预不了,不可控;(如对sql语句的优化等级非常高,不适合hibernate)
- 如果数据库特别大,不适合用hibernate;
1.5.P6Spy【开发调试工具】
P6Spy是一个可以拦截SQL执行过程,记录SQL执行过程,用于性能分析的功能。但是p6spy会对性能有一定影响,因此不适合在正式环境上使用。
实现原理:p6spy将应用的数据源给劫持了,应用操作数据库其实在调用p6spy的数据源,p6spy劫持到需要执行的sql之后,他自己去调用一个realDatasource,再去操作数据库。
- githubhttps://github.com/p6spy/p6spy
- 官网https://p6spy.readthedocs.io/en/latest/index.html
- 详细配置:https://p6spy.readthedocs.io/en/latest/configandusage.html
- P6Spy
使用方式
1. maven坐标
<dependency>
  <groupId>p6spy</groupId>
  <artifactId>p6spy</artifactId>
  <version>${p6spy.version}</version>
</dependency>

2.替换数据源
spring:
    datasource:
        type: com.alibaba.druid.pool.DruidDataSource
        driverClassName: ${DRIVER_CALSS_NAME:com.p6spy.engine.spy.P6SpyDriver}
        url: ${DATASOURCE_URL:jdbc:p6spy:mysql://localhost:3306/demo?useUnicode=true&characterEncoding=utf8&useSSL=false&serverTimezone=Asia/Shanghai}

3.在resource目录下添加spy.properties
#3.2.1以上使用
modulelist=com.baomidou.mybatisplus.extension.p6spy.MybatisPlusLogFactory,com.p6spy.engine.outage.P6OutageFactory
#3.2.1以下使用或者不配置
#modulelist=com.p6spy.engine.logging.P6LogFactory,com.p6spy.engine.outage.P6OutageFactory
# 自定义日志打印
#logMessageFormat=com.baomidou.mybatisplus.extension.p6spy.P6SpyLogger
logMessageFormat=com.github.lybgeek.p6spy.extentsion.CustomP6SpyLogger
#日志输出到控制台
#appender=com.baomidou.mybatisplus.extension.p6spy.StdoutLogger
# 使用日志系统记录 sql
#appender=com.p6spy.engine.spy.appender.Slf4JLogger
appender=com.github.lybgeek.p6spy.extentsion.CustomStdoutLogger
# 设置 p6spy driver 代理
deregisterdrivers=true
# 取消JDBC URL前缀
useprefix=true
# 配置记录 Log 例外,可去掉的结果集有error,info,batch,debug,statement,commit,rollback,result,resultset.
excludecategories=info,debug,result,commit,resultset
# 日期格式
dateformat=yyyy-MM-dd HH:mm:ss
# 实际驱动可多个
#driverlist=org.h2.Driver
# 是否开启慢SQL记录
outagedetection=true
# 慢SQL记录标准 2 秒
outagedetectioninterval=2

4.自定义日志格式【可选】。在spy.properties中配置自定义日志格式: logMessageFormat=com.github.lybgeek.p6spy.extentsion.CustomP6SpyLogger
public class CustomP6SpyLogger implements MessageFormattingStrategy {
    /**
     * Sql日志格式化
     * @param connectionId: 连接ID
     * @param now:          当前时间
     * @param elapsed:      花费时间
     * @param category:     类别
     * @param prepared:     预编译SQL
     * @param sql:          最终执行的SQL
     * @param url:          数据库连接地址
     * @return 格式化日志结果
     */
    @Override
    public String formatMessage(int connectionId, String now, long elapsed, String category, String prepared, String sql, String url) {
        return StringUtils.isNotBlank(sql) ? " 耗时:" + elapsed + " ms " + now +
                "\n 执行 SQL:" + sql.replaceAll("[\\s]+", " ") + "\n" : "";
    }
}

5、自定义日志输出【可选】。在spy.properties中配置自定义日志输出:appender=com.github.lybgeek.p6spy.extentsion.CustomStdoutLogger
public class CustomStdoutLogger extends com.p6spy.engine.spy.appender.StdoutLogger{
    @Override
    public void logText(String text) {
        System.out.println("sql:" + text);
    }
}

6、测试观察控制台输出
sql: 耗时:1 ms 2022-05-10 11:38:34
执行 SQL:SELECT id,username,password,fullname,mobile,email FROM t_user
2.Mybatis
- 源码:https://github.com/mybatis
- 文档:https://mybatis.org/mybatis-3/zh/index.html
- Mybatis3.3.x技术内幕,共23章
- 2万多行MyBatis源码,你知道里面用了多少种设计模式吗
- ParameterHandler源码解析
2.1.介绍
MyBatis 是一款优秀的持久层框架,它支持自定义 SQL、存储过程以及高级映射。 MyBatis 免除了几乎所有的 JDBC 代码以及设置参数和获取结果集的工作。 MyBatis 可以通过简单的 XML 或注解来配置和映射原始类型、接口和 Java POJO(Plain Old Java Objects,普通老式 Java 对象)为数据库中的记录。
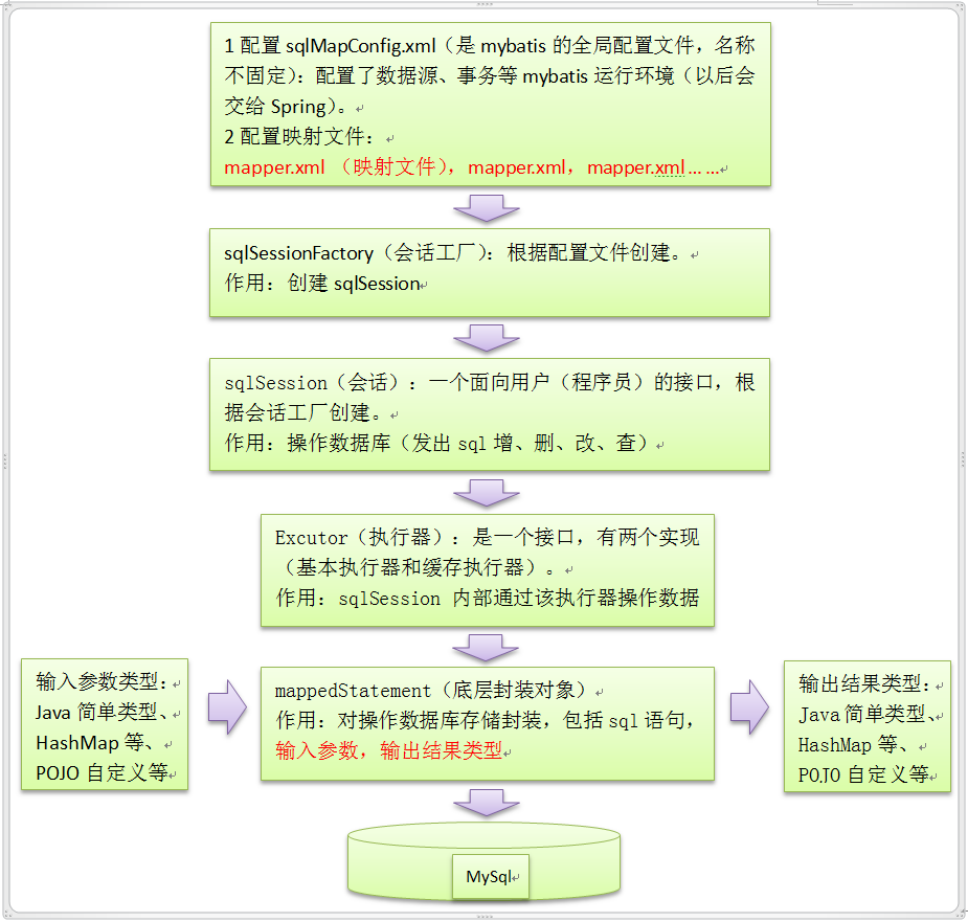
2.2.SQL执行流程
剖析Mybatis初始化过程中的六个工具:https://mp.weixin.qq.com/s/lgBW3UOPBKy89sos7bZBOg
2.3.设计模式
https://zhuanlan.zhihu.com/p/69092981
- Builder模式,例如SqlSessionFactoryBuilder、XMLConfigBuilder、XMLMapperBuilder、XMLStatementBuilder、CacheBuilder;
- 工厂模式,例如SqlSessionFactory、ObjectFactory、MapperProxyFactory;
- 单例模式,例如ErrorContext和LogFactory;
- 代理模式,Mybatis实现的核心,比如MapperProxy、ConnectionLogger,用的jdk的动态代理; 还有executor.loader包使用了cglib或者javassist达到延迟加载的效果;
- 组合模式,例如SqlNode和各个子类ChooseSqlNode等;
- 模板方法模式,例如BaseExecutor和SimpleExecutor,还有BaseTypeHandler和所有的子类例如IntegerTypeHandler;
- 适配器模式,例如Log的Mybatis接口和它对jdbc、log4j等各种日志框架的适配实现;
- 装饰者模式,例如Cache包中的cache.decorators子包中等各个装饰者的实现;
- 迭代器模式,例如迭代器模式PropertyTokenizer;
- 责任链模式,很多人都忽略了这个,凡是有拦截器、过滤器的都使用了这个
2.4.一级缓存与二级缓存
MyBatis的一级缓存实现详解 及使用注意事项:https://blog.csdn.net/chenyao1994/article/details/79233725
正确使用一级缓存: https://blog.csdn.net/u010841296/article/details/89763359
一级缓存的作用:不仅仅减少了查询次数,还在在程序层面上,帮助我们规避了不可重复读的问题。 一级缓存的生命周期是和SqlSession一样。默认事务自动提交,所以每执行一次SQL,SqlSession就会创建一次。 而开启事务后,SqlSession会贯穿整个事务,一级缓存也会一直生效,直到执行增删改语句后清空缓存。
如何实现复用SqlSession:事务托管到spring后,SqlSession是保存在spring提供的用于管理当前事务的ThreadLocal中,开始事务的时候,会设置一个状态值为开启事务,就可以复用SqlSession。
二级缓存:是全局的查询缓存,可被多个SqlSession共享。每个namespace都有自己的缓存,所有当namespace中执行了增删改语句后会清空缓存。
2.5.mybatis 的 ExecutorType 有三种
三种SQL执行的简单区别: https://blog.csdn.net/qq32933432/article/details/104514028
-
SIMPLE。默认的,也是使用最大的。每个SQL都会创建一个新的Statement ,使用后会关闭 Statement 。
-
REUSE。Statement 使用之后不会立刻关闭,会将预编译进行缓存,也就是PSCache。 可以理解为预编译是将SQL转为机器码,之后数据库执行机器码。 预编译是个比较耗时的过程,所以缓存这个的话,后面执行相同SQL的时候将减少了预编译的过程,提交了效率。
注意:这个对于使用场景是有要求的,如果程序中动态SQL非常多的话,是不推荐使用这个的,因为动态SQL越多, 参数数量的变化越多,缓存下来的ps使用率越低,占用的内存越大。
- BATCH。用于执行存储过程与批量操作。在一个事务当中,提交SQL不会立即执行,会先进行预编译, 将多个SQL的Statement保存到list中,之后再提交事务的时候批量执行Statement。感觉是个效率很高的操作,但其实效果一般。 可能比SIMPLE的高一点点。
注意:ExecutorType 的设置时在项目启动的时候进行设置的,如果我们需要使用多个ExecutorType, 是需要设置多个SQLSessionTemplate。如果动态的去进行设置。 所以我们一般项目中不会去设置ExecutorType的,比较会导致项目混乱, 还可能影响其他SQL的执行。 所以使用SIMPLE是比较好的折中方式。
如何提升批量插入的性能:依旧使用SIMPLE,但是可以通过通过sqlSession获得jdbc的connection,可以直接使用jdbc的batch功能,经过测试,性能提升30~50%。
2.6.SQL注入
我们都知道使用预编译,可以防止SQL注入。但是有些时候却不行
- 使用order by ${field} ${desc}。这两个值不能使用#{}。所以存在SQL注入的分险
- 模糊查询。Select * from news where title like ‘%${title}%'。这样写法虽然可以,但是存在SQL注入的分险
正确的写法: select * from news where tile like concat(‘%',#{title}, ‘%')
2.7. DAO 接口和 XML如何建立关系
DAO 接口和 XML SQL如何关联:https://mp.weixin.qq.com/s/w6AosXmHEHTVUAez7HnLWw
mybatis启动时会先解析xml,namespace是接口的类名称,id是接口中的方法名称。 调用SQL:执行Java代码的时候, 最终执行的时sqlSession的方法,通过通过statement(全限定类型+方法名)拿到MappedStatement 对象,然后通过执行器Executor去执行具体SQL并返回。
public class DefaultSqlSession implements SqlSession {
 public <E> List<E> selectList(String statement, Object parameter, RowBounds rowBounds) {
  try {
   MappedStatement ms=configuration.getMappedStatement(statement);
   return executor.query(ms,
    wrapCollection(parameter), rowBounds, Executor.NO_RESULT_HANDLER);
  }
 }
}
2.8.常见问题
- 在金融的大批次数据处理中,容易出现性能问题:https://mp.weixin.qq.com/s/X3Da_0bempgMgYr2Ft5kKA
- mybatis3.5.X版本,在参数处理和结果映射时使用jdk8提供的ConcurrentHashMap.computeIfAbsent, 这个方法内部采用了静态代码块。
- foreach性能差导致oom。https://mp.weixin.qq.com/s/WZ9HRM8p6HqWlKDQ7B7stg
- 事故1:druid开启sql性能监控。druid内部使用一个map缓存执行的sql。但是金融场景sql查询条件非常多(各种组合高达几万个)导致内存无法释放,不断FULL GC。
- 事故2:foreach拼接SQL性能差,内部通过正则的操作匹配占位符时需要较多的时间,同时又持有查询参数和占位符在ContextMap中无法被GC释放,所以一旦并发量上去就很容易内存占用过多导致OOM
2.9.Mybatis-Plus
- 官网:https://baomidou.com/
- 官方文档:https://baomidou.com/guide/
- 官方案例:https://github.com/baomidou/mybatis-plus-samples
- 使用mybatis plus的开源项目案例
- 简单教程
- 详细教程
是mybatis的操作简化,增强版。所有换来的是性能减低,一般情况下,性能会降低3~5倍。
特点
- 无侵入:只做增强不做改变,引入它不会对现有工程产生影响,如丝般顺滑
- 损耗小:启动即会自动注入基本 CURD,性能基本无损耗,直接面向对象操作。
- 强大的 CRUD 操作:内置通用 Mapper、通用 Service,仅仅通过少量配置即可实现单表大部分 CRUD 操作,更有强大的条件构造器,满足各类使用需求
- 支持 Lambda 形式调用:通过 Lambda 表达式,方便的编写各类查询条件,无需再担心字段写错
- 支持主键自动生成:支持多达 4 种主键策略(内含分布式唯一 ID 生成器 - Sequence),可自由配置,完美解决主键问题
- 支持 ActiveRecord 模式:支持 ActiveRecord 形式调用,实体类只需继承 Model 类即可进行强大的 CRUD 操作
- 支持自定义全局通用操作:支持全局通用方法注入( Write once, use anywhere )
- 内置代码生成器:采用代码或者 Maven 插件可快速生成 Mapper 、 Model 、 Service 、 Controller 层代码,支持模板引擎,更有超多自定义配置等您来使用
- 内置分页插件:基于 MyBatis 物理分页,开发者无需关心具体操作,配置好插件之后,写分页等同于普通 List 查询
- 分页插件支持多种数据库:支持 MySQL、MariaDB、Oracle、DB2、H2、HSQL、SQLite、Postgre、SQLServer 等多种数据库
- 内置性能分析插件:可输出 SQL 语句以及其执行时间,建议开发测试时启用该功能,能快速揪出慢查询
- 内置全局拦截插件:提供全表 delete 、 update 操作智能分析阻断,也可自定义拦截规则,预防误操作
提供了乐观锁插件、分页插件、多租户插件、防全表更新与删除插件。
对于企业级应用,还支持:数据加密、数据脱敏、数据权限、敏感词、分库分表、分布式ID等功能(免费的)
MyBatis-Plus踩坑血泪史:那些年我们踩过的坑!
- 雪花算法ID生成重复问题。MP中workerId是5bit(0~31),可以自行设置。解决方案:给每台机器一个专属身份证
- 核心原因是:workerId使用了默认值。可能的原因包括以下几个。
- 1.没有设置workerId,MP会尝试通过MAC计算workerId,但是在容器环境下可能无法获得地址,导致使用了默认值。
- 2.MP使用32取模,如果服务实例超过31,导致workerId重复。
- 3.K8s中使用CNI分配MAC地址,无法被pod内获取到。
- 4.时钟回拨
- 批量插入乱序问题。
- 原因1:MP提供两种批量保存方法:1.默认BATCH模式(逐条插入)支持返回ID,内部使用多线程,会导致顺序乱序。另一种是拼接SQL插入,也是我们推荐使用的。
- 原因2:MySQL JDBC驱动为了提速,会把同表操作合并。原本交错的SQL被重新分组,顺序自然就乱了。在URL中添加设置禁用:rewriteBatchedStatements=false
- 枚举字段存储风险。程序中为枚举,数据库中非枚举。如果枚举不是简单的name结构就会出现问题。解决:使用@EnumValue注解。
- 驼峰转换错位。例如:数据库中seller_uid,必须映射为 sellerUid。如果写成sellerUId就会映射错误。解决:使用@TableField注解。
- 批量操作时自动填充失效。MP自动填充是通过自定义MetaObjectHandler,而saveBatch没有调用MetaObjectHandler,导致无法自动填充。解决:只能手动填充。
- 写入时JSON数据丢失或格式异常。MyBatis默认只能处理基本类型,只能自行序列化处理。
2.10.FastMyBatis
- 官网:https://torna.cn/
- 开源:https://gitee.com/durcframework/fastmybatis
- 案例:一个纯净的后台管理系统,具备基本的RBAC权限校验功能,权限校验精确到按钮级别。前端使用Vue3、Vite5、Element-Plus、TypeScript、Pinia、Tailwindcss, 后端采用SpringBoot3.4 + Java17 + fastmybatishttps://gitee.com/durcframework/fm-admin
fastmybatis (opens new window)是一个mybatis开发框架,其宗旨为:简单、快速、有效。
3.连接池
数据库连接池负责分配、管理和释放数据库连接,它允许应用程序重复使用一个现有的数据库连接,而不是再重新建立一个;
释放空闲时间超过最大空闲时间的数据库连接来避免因为没有释放数据库连接而引起的数据库连接遗漏。这项技术能明显提高对数据库操作的性能。
3.1.常见数据库连接池
Java程序想要连接到数据库,需要使用到的技术也是不同的。
- 关系型数据库:主要使用JNDI或者jdbc进行连接,数据库连接池可以提交效率
- JNDI:JNDI(Java Naming and Directory Interface)是Java提供的Java 命名和目录接口。可以操作DataSource,比如weblogic、Tomcat都支持JNDI连接数据库。
- Druid:阿里巴巴开源,功能非常强
- HikariCP。HikariCP 是一个高性能的 JDBC 连接池组件,号称性能最好的后起之秀,是一个基于BoneCP做了不少的改进和优化的高性能JDBC连接池,是springboot默认连接池。
- C3P0:是一个开放源代码的JDBC连接池,它在lib目录中与Hibernate一起发布,包括了实现jdbc3和jdbc2扩展规范说明的Connection 和Statement 池的DataSources 对象。 http://www.mchange.com/projects/c3p0/
- DBCP:DBCP是一个依赖Jakarta commons-pool对象池机制的数据库连接池。DBCP可以直接的在应用程序中使用。 http://commons.apache.org/proper/commons-dbcp/configuration.html
- Proxool:是一个Java SQL Driver驱动程序,提供了对选择的其它类型的驱动程序的连接池封装。可以非常简单的移植到现存的代码中,完全可配置,快速、成熟、健壮。可以透明地为现存的JDBC驱动程序增加连接池功能。
- DDConnectionBroker:是一个简单、轻量级的数据库连接池。
- DBPool:是一个高效、易配置的数据库连接池。它除了支持连接池应有的功能之外,还包括了一个对象池,使用户能够开发一个满足自己需求的数据库连接池。
- XAPool:是一个XA数据库连接池。它实现了javax.sql.XADataSource并提供了连接池工具。
- Primrose:是一个Java开发的数据库连接池。当前支持的容器包括Tomcat4&5、Resin3与JBoss3。它同样也有一个独立的版本,可以在应用程序中使用而不必运行在容器中。 Primrose通过一个WEB接口来控制SQL处理的追踪、配置,以及动态池管理。在重负荷的情况下可进行连接请求队列处理。
- SmartPool:是一个连接池组件,它模仿应用服务器对象池的特性。SmartPool能够解决一些临界问题如连接泄漏(connection leaks)、连接阻塞、打开的JDBC对象(如Statements、PreparedStatements)等。
- MiniConnectionPoolManager:是一个轻量级JDBC数据库连接池。它只需要Java1.5(或更高)并且没有依赖第三方包。
- BoneCP:是一个快速、开源的数据库连接池。帮用户管理数据连接,让应用程序能更快速地访问数据库。比C3P0/DBCP连接池速度快25倍。
- 键值型数据库:Redis,客户端较多,比如jedis、lettuce、Redisson等
- Jedis:基于socket实现的客户端,采用面向过程的方式,与Redis进行通信。调用的接口与Redis命令十分接近。
- Redisson:基于jedis实现的高级客户端。采用面向对象的流式方式。实现了很多分布式环境下的高级特性。
- Lettuce:基于socket实现的客户端。spring-data-Redis基于lettuce实现的RedisTemplate。
其中比较主流的是 hikariCP、Druid、C3P0、DBCP。
3.2.性能测评
https://cloud.tencent.com/developer/article/1793078
测试结论
- 性能方面 hikariCP>druid>tomcat-jdbc>dbcp>c3p0 。hikariCP的高性能得益于最大限度的避免锁竞争。
- druid功能最为全面,sql拦截等功能,统计数据较为全面,具有良好的扩展性。
- 综合性能,扩展性等方面,可考虑使用druid或者hikariCP连接池。
- 可开启prepareStatement缓存,对性能会有大概20%的提升,尤其是SQL是确定的场景,如果SQL动态变化大,例如in条件数量从1到几千个不止,可能会造成内存耗尽。
3.3.配置优化
数据库连接池优化配置(druid,dbcp,c3p0)
主要描述了数据库连接池参数配置的准则,针对常用的数据库连接池(c3p0,dbcp,druid)给出推荐的配置。
考虑因素
- 当前连接DB的规模
- 并发情况
- 执行db的响应时间
配置考虑
- 初始化连接. 可考虑设置为3个连接。对于db规模特别大的情况下可考虑设置为1个,避免启动时间过长;
- 最小连接. 可考虑该值的设置和初始化连接保持一致;
- 最大连接. 对于有较大DB规模,最大连接不要设置过大,避免本地维护的db太大。 如果对应到数据源的并发数过高,可考虑增大最大连接数。
- 获取连接的超时时间. 如果连接全部被占用,需要等待的时间。可以根据当前系统的响应时间判定,如果容忍度较高,可以大点。容忍度较低,设置小点。
- 当获取连接和释放连接心跳检测. 建议全部关闭,否则每个数据库访问指令会对数据库生产额外的两条心跳检测的指令,增加数据库的负载。连接有效性的检查改用后台空闲连接检查。
- 连接有效性检测时间. 该值需要结合数据库的wait_timeout,interactive_timeout值进行设置。假如数据库为120s,则心跳检测时间在120s以内越大越好。如果太小,心跳检测时间会比较频繁。建议设置为90s。
- 最大空闲时间. 如果连接超过该时间没有使用过,则会进行close掉。 该值不要太小,避免频繁的建立连接关闭连接。也不要太大,导致一直无法关闭。
- 心跳检查的sql语句. 尽量使用ping命令,ping的性能较查询语句高。大部分的数据库连接池不配置query语句,便会调用ping命令。
- prepareStatement缓存. 可以根据自己的业务来判定是否开启。开启后对性能的影响依赖于具体业务和并发情况。可考虑暂时不开启。
- 连接使用超时. 业务拿到一个连接,如果超过指定的时间未归还,是否把该连接给给回收掉。超时时间等和具体的业务关联。暂时建议先不开启。
4.Druid
- 官网:https://github.com/alibaba/druid
- 文档:https://github.com/alibaba/druid/wiki
- 教程: https://mp.weixin.qq.com/s/s7s05Rr7Nl64oZu_UVaRMg
- Spring boot整合教程:https://www.cnblogs.com/defineconst/p/10879824.html
4.1.介绍
Druid不仅是一个数据库连接池,还包含一个ProxyDriver、一系列内置的JDBC组件库、一个SQL Parser。 支持所有JDBC兼容的数据库,包括Oracle、MySql、Derby、Postgresql、SQL Server、H2等。 尤其是支持国产数据库,是其他所有数据库连接池所不能比较的。
支持的功能:
- Druid数据源(连接池): 如同c3p0、dbcp数据源可以设置数据源连接初始化大小、最大连接数、等待时间、最小连接数 等一样,Druid数据源同理可以进行设置。
- Druid web监控filter(WebStatFilter): 这个过滤器的作用就是统计web应用请求中所有的数据库信息,比如 发出的sql语句,sql执行的时间、请求次数、请求的url地址、以及seesion监控、数据库表的访问次数等等。
- Druid后台管理Servlet(StatViewServlet): Druid数据源具有监控的功能,并提供了一个web界面方便用户查看,类似安装 路由器 时,人家也提供了一个默认的web页面;需要设置Druid的后台管理页面的属性,比如 登录账号、密码等。
Druid针对Oracle和MySql做了特别优化,比如:
- Oracle的PS Cache内存占用优化
- MySql的ping检测优化
Druid提供了MySql、Oracle、Postgresql、SQL-92的SQL的完整支持,这是一个手写的高性能SQL Parser,支持Visitor模式,使得分析SQL的抽象语法树很方便。
简单SQL语句用时10微秒以内,复杂SQL用时30微秒。 通过Druid提供的SQL Parser可以在JDBC层拦截SQL做相应处理,比如说分库分表、审计等。 Druid防御SQL注入攻击的WallFilter,就是通过Druid的SQL Parser分析语义实现的。
4.2.使用技巧
4.2.1.口令加密配置
数据库密码加密:【重要】数据库密码加密
filter配置
- 监控sql统计 stat: 不建议开启,因为DruidDataSource持有JdbcDataSourceStat会记录所有执行过的SQL,不会被gc,容易发生oom。通常也没有人关心这个监控。
- 安全防护wall:不是必选项,添加后会基于自带的安全策略对所有执行SQL进行判断,可能会影响部分SQL执行,可以选择不添加。
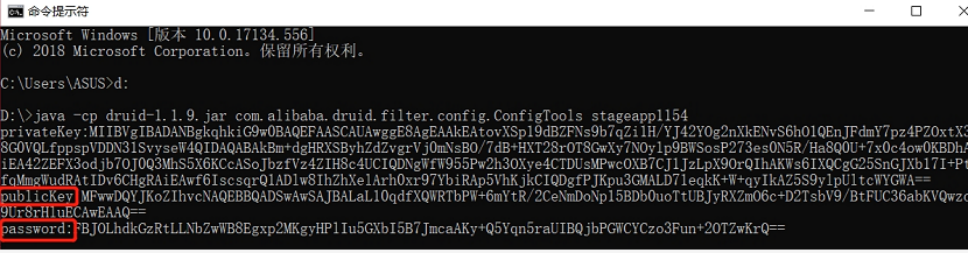
druid自带加密解密工具。
- 进入 druid-1.2.1.jar所在目录
- 执行java -cp druid-1.2.1.jar com.alibaba.druid.filter.config.ConfigTools 【明文口令】 获得加密后的密文 和 公钥、私钥。项目当中配置公钥即可。
4.2.2.监控指标
druid开启监控后,接口提供JSON格式的指标数据,可以用于监控系统读取。
PS:只能通过监控系统主导读取。druid没有提供指标上报的功能,当然自己也可以实现export组件,上报给监控系统。
问题:如何区分谁上报的?
- 方案1:url内部提供参数。jdbc:mysql://10.7.129.2:3306/sundb?applicationName=my_project
4.3.最佳实践
######################################
###                              #####
###       数据源基本信息           #####
###                              #####
######################################
spring.datasource.type=com.alibaba.druid.pool.DruidDataSource
spring.datasource.driverClassName=com.mysql.cj.jdbc.Driver

spring.datasource.druid.url=jdbc:mysql://127.0.0.1:3306/test?serverTimezone=Asia/Shanghai&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true&failOverReadOnly=false&useSSL=false&zeroDateTimeBehavior=convertToNull&allowMultiQueries=true
spring.datasource.druid.username=root
# 部署环境不可使用明文口令,需使用密文
spring.datasource.druid.password=UqZXNYg5QuaW7idEjE+Vsh05lBqvJI9ohE9jTfEPCsls2wNBLRkg2n2ccXsha7S1O5L/Jx4xz91FkCX/gAjacw==

######################################
###                              #####
###       连接参数配置             #####
###                              #####
######################################
# 【推荐】数据库密码加密配置,配置解密的秘钥
spring.datasource.druid.connect-properties.config.decrypt=true
spring.datasource.druid.connect-properties.config.decrypt.key=MFwwDQYJKoZIhvcNAQEBBQADSwAwSAJBAK9lqNx6JLlF0lJ68FMdG4xEFBsaqVG6sCnG6PYvoQkclQhMClsKNeY2jV7CvXemjwxojnuLqSRV4m8LzMcVJNUCAwEAAQ==

# 【不推荐开启】通过connectProperties属性来打开mergeSql、慢SQL记录等功能
spring.datasource.druid.connect-properties.druid.stat.mergeSql=true
spring.datasource.druid.connect-properties.druid.stat.slowSqlMillis=500

# 【推荐】异步初始化线程池数量,用于加快项目的启动速度,默认关闭
spring.datasource.druid.async-init=true

######################################
###                              #####
###       连接数量信息             #####
###                              #####
######################################
# 1. 连接数量配置
# 初始化时,连接池数量。需配置为1,以提升应用使用数据源连接效率,同时便于监控平台识别连接池是否可用
spring.datasource.druid.initial-size=1
# 最大连接池数量 根据实际使用需求设置,不应超过应用服务最大请求并发数
spring.datasource.druid.max-active=20
# max-idle已经废弃无法使用
# 最小空闲池数量
spring.datasource.druid.min-idle=5

######################################
###                              #####
###       空闲连接检测【建议开启】   #####
###                              #####
######################################
# 空闲连接保留时限(单位毫秒,默认 180000,即30分钟,空闲连接检测线程如果检测到当前连接空闲时间大于 min-evictable-idle-time-millis,则关闭当前连接
spring.datasource.druid.min-evictable-idle-time-millis=90000

# 空闲连接检测周期(单位毫秒,默认-1,表示不运行检测,此配置同时也是testWhileIdle的判断依据)
# 需配置为30000,代表每30秒检测一次池中是否有空闲连接,结合min-evictable-idle-time-millis配置避免应用占用过多非活动连接
spring.datasource.druid.time-between-eviction-runs-millis=30000

######################################
###
###  内存泄漏检测【活动连接检测】
### 【不建议在生产环境中使用,对性能会有一些影响,建议怀疑存在泄漏之后再打开】
######################################
# 是否开启强制关闭活动连接(对于建立时间超过removeAbandonedTimeout的连接强制关闭,默认false),需配置为true,避免应用连接泄露或SQL执行时间过长
spring.datasource.druid.remove-abandoned=true

# 活动连接最大开启时间(单位秒,默认300秒,需配合removeAbandoned生效)
# 不包含批处理SQL的应用需配置为300,包含批处理SQL的应用配置为允许SQL执行的最大时间,避免应用连接泄露或SQL执行时间过长
spring.datasource.druid.removeAbandonedTimeout=300

# 强制关闭活动连接后,是否打印一条log(默认false,需配合removeAbandoned生效)
# 需配置为true,便于监控处理连接泄露或SQL执行时间过长问题
spring.datasource.druid.logAbandoned=true


######################################
###                              #####
###       连接有效性检测            #####
###                              #####
######################################
#用来检测连接是否有效的sql 必须是一个查询语句
#mysql中为 select 'x'
#oracle中为 select 1 from dual
spring.datasource.druid.validation-query=select 1

# 获取连接时最大等待时间,单位毫秒。此配置配置不宜配置过短(增加网络抖动报错)或过长(增加数据源不可用时等待时间导致请求阻塞)
spring.datasource.druid.max-wait=1000

# 申请连接时会执行validationQuery检测连接是否有效,开启会降低性能,默认为true
spring.datasource.druid.test-on-borrow=false

# 归还连接时会执行validationQuery检测连接是否有效,开启会降低性能,默认为true
spring.datasource.druid.test-on-return=false

# 申请连接的时候检测,是否检测池中空闲连接可用性(如果空闲时间大于timeBetweenEvictionRunsMillis,将执行validationQuery检测)
spring.datasource.druid.test-while-idle=true

#是否缓存preparedStatement,mysql5: 5+建议开启
spring.datasource.druid.pool-prepared-statements=true

#当值大于0时poolPreparedStatements会自动修改为true
spring.datasource.druid.max-pool-prepared-statement-per-connection-size=20

######################################
###                              #####
###            filter            #####
###                              #####
######################################
# 属性类型是字符串,通过别名的方式配置扩展插件,常用的插件有:
# 详细的配置可以看 DruidFilterConfiguration 中的 filter
#       监控统计sql:      stat          不建议开启,因为DruidDataSource持有JdbcDataSourceStat会记录所有执行过的SQL,不会被gc,容易发生oom
#       日志输出:         log4j,slf4j,log4j2   这三种选择一种就行
#       防御sql注入:      wall          不建议开启,对性能影响大。
#       密码加密:        config        1、从配置文件中读取配置;2、从远程http文件中读取配置;3、为数据库密码提供加密功能。
spring.datasource.druid.filters=config,wall,stat,log4j2

# 启动 ConfigFilter
spring.datasource.druid.filter.config.enabled=true

# 配置StatFilter:用于统计监控信息
spring.datasource.druid.filter.stat.enabled=true
spring.datasource.druid.filter.stat.db-type=mysql
# 开启慢SQL记录功能
spring.datasource.druid.filter.stat.log-slow-sql=true
# 默认3000毫秒,这里超过2s,就是慢,记录到日志
spring.datasource.druid.filter.stat.slow-sql-millis=2000

# 配置WallFilter:通过Druid的SQL Parser分析防御SQL注入攻击,
spring.datasource.druid.filter.wall.enabled=true
spring.datasource.druid.filter.wall.db-type=mysql
spring.datasource.druid.filter.wall.config.delete-allow=false
spring.datasource.druid.filter.wall.config.drop-table-allow=false

# 配置log4jFilter:日志记录的功能,可以把sql语句打印到log4j2供排查问题【跟日志级别无关】
spring.datasource.druid.filter.log4j2.enabled=true

######################################
###                              #####
###            sql监控            #####
###                              #####
######################################
#是否启用StatFilter默认值false,用于采集 web-jdbc 关联监控的数据。
spring.datasource.druid.web-stat-filter.enabled=true
#需要监控的 url
spring.datasource.druid.web-stat-filter.url-pattern=/*
#排除一些静态资源,以提高效率
spring.datasource.druid.web-stat-filter.exclusions=*.js,*.gif,*.jpg,*.png,*.css,*.ico,/druid/*
# 开启session统计功能
spring.datasource.druid.web-stat-filter.session-stat-enable=true
# session的最大个数,默认100
spring.datasource.druid.web-stat-filter.session-stat-max-count=1000


######################################
###                              #####
###         spring监控            #####
###                              #####
######################################
#访问之后spring监控默认是没有数据的,但需要导入SprngBoot的AOP的
spring.datasource.druid.aop-patterns=com.zx.pool.*

######################################
###                              #####
###         监控界面配             #####
###                              #####
######################################
# 登录查看信息的账号和密码
spring.datasource.druid.stat-view-servlet.login-username=admin
spring.datasource.druid.stat-view-servlet.login-password=admin

#是否启用StatViewServlet(监控页面)默认值为false(考虑到安全问题默认并未启动,如需启用建议设置密码或白名单以保障安全)
spring.datasource.druid.stat-view-servlet.enabled=true
#内置的监控页面地址,例如 /druid/*,则内置监控页面的首页是 /druid/index.html
spring.datasource.druid.stat-view-servlet.url-pattern=/druid/*

# IP白名单
#spring.datasource.druid.stat-view-servlet.allow=127.0.0.1
# IP黑名单(同时存在时,deny优先于allow)
#spring.datasource.druid.stat-view-servlet.deny=192.169.3.51
#是否允许清空统计数据
spring.datasource.druid.stat-view-servlet.reset-enable=false

######################################
###       Mock 数据源            #####
######################################
## 实现应用的无数据源启动,数据源的任何操作都不会报错,但是没不会有执行成功
#spring.datasource.driverClassName=com.alibaba.druid.mock.MockDriver
#spring.datasource.druid.url=jdbc:fake://  # 以 jdbc:fake: 开头即可, 后面的部分可有可无
5.HikariCP
HikariCP为什么这么快?
- 两个HikariPool:HikariDataSource定义了两个HikariPool对象,一个采用final类型定义,避免在获取连接时才初始化,提高性能,也避免volatile的额外开销。
- FastList替代ArrayList:采用自定义的FastList替代了ArrayList,FastList的get方法去除了范围检查逻辑,并且remove方法是从尾部开始扫描的,而并不是从头部开始扫描的。因为Connection的打开和关闭顺序通常是相反的。
- 更快的并发集合实现:使用自定义ConcurrentBag,性能更优。
- 更快的获取连接:同一个线程获取数据库连接时从ThreadLocal中获取,没有并发操作。
- 精简字节码:HikariCP利用了一个第三方的Java字节码修改类库Javassist来生成委托实现动态代理,速度更快,相比于JDK 代理生成的字节码更少。
- 本文作者:zhangxue
- 本文链接:https://lucksnow1989.github.io/article/7.数据库/2.持久化&连接池.html
- 版权声明:本文为本人原创文章,遵循 CC 4.0 BY-NC-SA版权协议,转载请附上原文出处链接和本声明。