 张雪随笔
Eureka
1.介绍
Eureka 是Netflix开发的服务发现组件,使用REST提供服务。Spring Cloud将它集成在其子项目 spring-cloud-netflix 中, 以实现 Spring Cloud 的服务注册于发现, 同时还提供了负载均衡、 故障转移等能力。
特点
- 可用性(AP原则):Eureka 在设计时就紧遵AP原则,Eureka的集群中,只要有一台Eureka还在,就能保证注册服务可用,只不过查到的信息可能不是最新的(不保证强一致性)。
- 去中心化架构:Eureka 可以运行多个实例来构建集群,不同于 ZooKeeper的选举 leader 的过程,Eureka Server 采用的是Peer to Peer 对等通信。 这是一种去中心化的架构,无 master/slave 之分,每一个 Peer 都是对等的。节点通过彼此互相注册来提高可用性,每个节点需要添加一个或多个有效的 serviceUrl 指向其他节点,每个节点都可被视为其他节点的副本。
- 请求自动切换:在集群环境中如果某台Eureka Server宕机,Eureka Client 的请求会自动切换到新的Eureka Server节点上,当宕机的服务器重新恢复后,Eureka会再次将其纳入到服务器集群管理之中。
- 节点间操作复制:当节点开始接受客户端请求时,所有的操作都会在节点间进行复制操作,将请求复制到该 Eureka Server 当前所知的其它所有节点中。
- 自动注册&心跳:当一个新的 Eureka Server 节点启动后,会首先尝试从邻近节点获取所有注册列表信息,并完成初始化。Eureka Server 通过 getEurekaServiceUrls() 方法获取所有的节点,并且会通过心跳契约的方式定期更新。
- 自动下线:默认情况下,如果 Eureka Server 在一定时间内没有接收到某个服务实例的心跳(默认周期为30秒),Eureka Server 将会注销该实例(默认为90秒, eureka.instance.lease-expiration-duration-in-seconds 进行自定义配置)。
- 保护模式:当 Eureka Server 节点在短时间内丢失过多的心跳时,那么这个节点就会进入自我保护模式。如果在15分钟内超过 85% 的节点都没有正常的心跳,那么Eureka就认为客户端与注册中心出现了网络故障,此时会出现以下几种情况:
- Eureka不再从注册表中移除因为长时间没有收到心跳而过期的服务;
- Eureka仍然能够接受新服务注册和查询请求,但是不会被同步到其它节点上(即保证当前节点依然可用)
- 当网络稳定时,当前实例新注册的信息会被同步到其它节点中。
总结:
- Eureka 是采用了去中心化的设计思想,通过点对点的方式进行节点间数据同步,实现数据最终一致性。(注册中心可用性高于一致性,可以接受短期数据不一致)
- 客户端发现模式:一切由客户端说的算,如果某个Eureka服务出现问题,客户端在向这个Eureka注册发现连接失败,则会自动切换至其它节点,只要有一台Eureka还在,就能保证注册服务可用。
Eureka就是一个高可用、易于使用、扩展性强、配置灵活以及自我保护机制的注册表,没有使用任何共识算法(通过点对点同步实现),简单易于理解。 非常适合,小型微服务架构、跨地域(内置region和zone概念)等场景。
2.安装使用
2.1.集群架构
服务拓扑图如下: 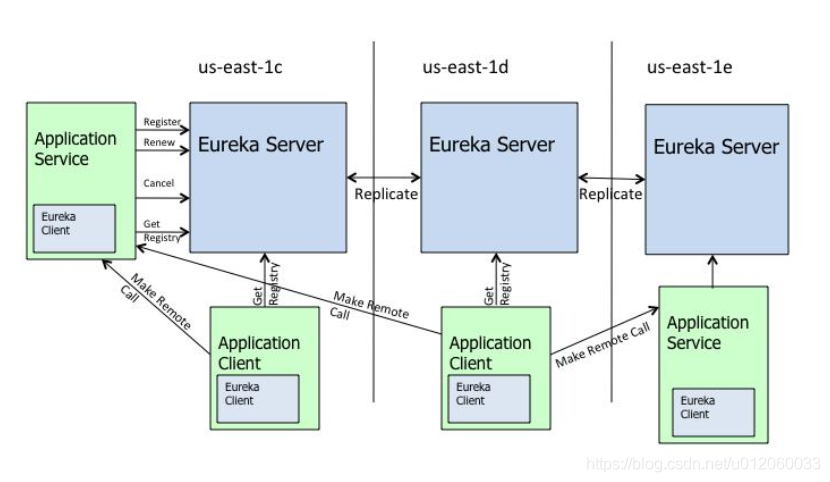
涉及到3中角色:
- Eureka Server:通过 Register、 Get、 Renew 等接口提供服务的注册和发现。
- Application Service:服务提供方,把自身的服务实例注册到 Eureka Server 中
- Application Client: 服务调用方,通过获取服务列表,发现服务提供方的ip端口进行调用。
角色之间的工作:
- Register(服务注册): 客户端 把自己的 IP 和端口注册给 Eureka。
- Renew(服务续约): 客户端主动发送心跳包, 每 30 秒发送一次,告诉 Eureka 自己还活着。
- Cancel(服务下线): 客户端关闭时会向 Eureka 发送消息, 把自己从服务列表中删除。防止 consumer 调用到已下线的服务发生异常。
- Get Registry(获取服务注册列表): 因为Eureka注册表没有隔离性,所以每个客户端会拉取全部的注册表。
- Replicate(集群中数据同步): eureka 集群中的数据会相互复制与同步,到达数据的最终一致性。
- Make Remote Call(远程调用): 客户端之间完成服务间的远程调用。
内部枚举如下:
1. 实例状态。枚举:InstanceStatus
    UP              示例已注册成功
    DOWN            示例已下线
    STARTING        示例开始注册(中间状态)
    OUT_OF_SERVICE  不提供服务
    UNKNOWN         未知状态
2 实例操作类型。参考:PeerAwareInstanceRegistryImpl.Action
    Heartbeat               心跳检查
    Register                注册
    Cancel                  取消
    StatusUpdate            状态变更
    DeleteStatusOverride    删除
3.任务处理结果。参考:TaskProcessor.ProcessingResult
    Success             成功,服务端返回200~300,不包含300
    Congestion          拥堵,比如服务繁忙503、超时异常
    TransientError      处理异常,可重试。主要通过判断是否IOException
    PermanentError      处理异常
2.2.工作流程
- Eureka Server 启动成功,等待服务端注册。在启动过程中如果配置了集群,集群之间定时通过 Replicate 同步注册表,每个Eureka Server都保存独立完整的服务注册表信息。
- Eureka Client 启动时根据配置的 Eureka Server 地址去注册中心注册服务。
- Eureka Client 会每 30s 向Eureka Server发送一次心跳请求,证明客户端服务正常。
- 当 Eureka Server 90s 内没有收到 Eureka Client 的心跳,注册中心则认为该节点失效,会注销该实例。
- 单位时间内 Eureka Server 统计到有大量的Eureka Client没有上送心跳,则认为可能为网络异常,进入自我保护机制,不再剔除没有上送心跳的客户端。
- 当 Eureka Client 心跳请求恢复正常之后,Eureka Server 自动退出自我保护模式。
- Eureka Client 定时全量或者增量从注册中心获取服务注册表,并且将获取到的信息缓存到本地。
- 服务调用时,Eureka Client 会先从本地缓存找寻调取的服务。如果获取不到,先从注册中心刷新注册表,再同步到本地缓存。
- Eureka Client 获取到目标服务器信息,发起服务调用。
- Eureka Client 程序关闭时向 Eureka Server 发送取消请求,Eureka Server 将实例从注册表中删除。
简单来说,eureka为了保证高可用,只能实现数据的最终一致性(弱一致性,短时间内会出现数据不一致的问题)
2.3.高可用
常用的高可用方案有两个
- 单数据中心内部,启动多个eureka实例,实例之间相互注册,实现集群搭建。
- 多数据中心内部,用户量比较大或者用户地理位置分布范围很广的项目,一般都会有多个机房。 我们希望一个机房内的服务优先调用同一个机房内的服务,当同一个机房的服务不可用的时候,再去调用其它机房的服务,以达到减少延时的作用。
PS: 集群使用域名或者ip对外提供服务。配置的方式稍有不同。 本地模拟搭建集群,必须使用域名。否则集群不可用。
2.3.1.单数据中心高可用集群
eureka服务配置相同的地址,启动后就可以相互注册。
eureka.client.fetch-registry=true
eureka.client.register-with-eureka=true
eureka.client.service-url.defaultZone=http://10.10.10.1:9001/eureka/,http://10.10.10.2:9001/eureka/,http://10.10.10.2:9001/eureka/
2.3.2.多数据中心高可用集群
eureka提供了region和zone两个概念来进行分区,这两个概念均来自于亚马逊的AWS:
- region:可以简单理解为地理上的分区,比如亚洲地区,或者华北地区,再或者北京等等,没有具体大小的限制。根据项目具体的情况,可以自行合理划分region。
- zone:可以简单理解为region内的具体机房,比如说region划分为北京,然后北京有两个机房,就可以在此region之下划分出zone1,zone2两个zone。
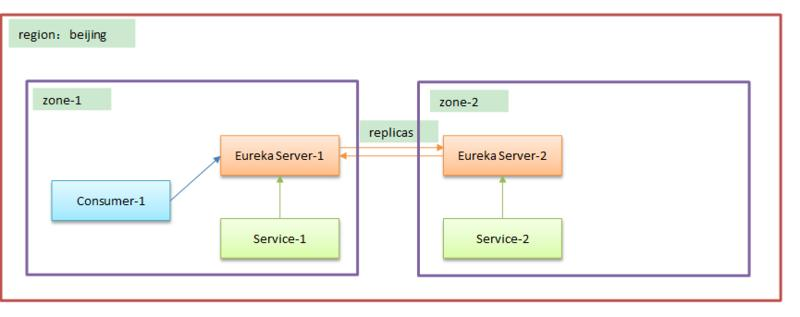
PS:eureka是基于AWS云的网络配置实现的。在公有云的维度,一般情况下,region之间网络是不通,同一个region下的zone之间网络互通。 当然互通的前提是必须使用同一个VPC。【公有云是基于VPC进行网络隔离的】
eureka服务配置如下。在3个zone中分别部署集群。集群之间也会定时相互同步注册信息,当zone的集群出现问题后,可以直接进行切换。
##########################
##  1.本实例的数据中心信息 ##
##########################
# 实例所在的地区。默认为us-east-1
eureka.client.region=beijing
# 实例是否使用同一zone里的eureka服务器,默认为true,理想状态下,eureka客户端与服务端是在同一zone下
eureka.client.prefer-same-zone-eureka=true
# 获取实例所在的地区下可用性的区域列表,用逗号隔开。(根据AWS云实际情况设计的高可用方案)
eureka.client.availability-zones.beijing=zone-1,zone-2,zone-3
eureka.client.fetch-registry=true
eureka.client.register-with-eureka=true

##########################
##  2.多数据中心的配置信息 ##
##########################
eureka.client.service-url.zone-1=http://ip1/eureka/,http://ip2/eureka/,http://ip3/eureka/
eureka.client.service-url.zone-2=http://ip4/eureka/,http://ip5/eureka/,http://ip6/eureka/
eureka.client.service-url.zone-3=http://ip7/eureka/,http://ip8/eureka/,http://ip9/eureka/
erueka客户端的配置如下
##########################
## 1.本实例的数据中心信息 ##
##########################
# 获取实例所在的地区。默认为us-east-1
eureka.client.region=beijing
#实例是否使用同一zone里的eureka服务器,默认为true,理想状态下,eureka客户端与服务端是在同一zone下
eureka.client.prefer-same-zone-eureka=true
# 获取实例所在的地区下可用性的区域列表,用逗号隔开。(根据AWS云实际情况设计的高可用方案)
# 顺序最重要,优先注册到第一个zone
eureka.client.availability-zones.beijing=zone-2,zone-1,zone-3
eureka.client.fetch-registry=true
eureka.client.register-with-eureka=true

##########################
## 2.多数据中心的配置信息 ##
##########################
eureka.client.service-url.zone-1=http://ip1/eureka/,http://ip2/eureka/,http://ip3/eureka/
eureka.client.service-url.zone-2=http://ip4/eureka/,http://ip5/eureka/,http://ip6/eureka/
eureka.client.service-url.zone-3=http://ip7/eureka/,http://ip8/eureka/,http://ip9/eureka/

##########################
## 3.最重要的配置,表示自己当前属于哪个zone
## 同时修改availability-zones中的zone顺序,将zone-2调整到第一的位置
## 服务消费者和服务提供者分别属于哪个zone,均是通过eureka.instance.metadata-map.zone来判定的。
## 服务消费者会先通过ribbon去注册中心拉取一份服务提供者的列表,然后通过eureka.instance.metadata-map.zone指定的zone进行过滤,过滤之后如果同一个zone内的服务提供者有多个实例,则会轮流调用。
## 只有在同一个zone内的所有服务提供者都不可用时,才会调用其它zone内的服务提供者
##########################
eureka.instance.metadata-map.zone=zone-2
2.4.全部配置
####################################################
#############    server配置           ###############
####################################################
#服务端开启自我保护模式,前面章节有介绍
eureka.server.enable-self-preservation=true
#扫描失效服务的间隔时间(单位毫秒,默认是60*1000)即60秒
eureka.server.eviction-interval-timer-in-ms= 60000
#间隔多长时间,清除过期的 delta 数据
eureka.server.delta-retention-timer-interval-in-ms=0
#请求频率限制器
eureka.server.rate-limiter-burst-size=10
#是否开启请求频率限制器
eureka.server.rate-limiter-enabled=false
#请求频率的平均值
eureka.server.rate-limiter-full-fetch-average-rate=100
#是否对标准的client进行频率请求限制。如果是false,则只对非标准client进行限制
eureka.server.rate-limiter-throttle-standard-clients=false
#注册服务、拉去服务列表数据的请求频率的平均值
eureka.server.rate-limiter-registry-fetch-average-rate=500
#设置信任的client list
eureka.server.rate-limiter-privileged-clients=
#在设置的时间范围类,期望与client续约的百分比。
eureka.server.renewal-percent-threshold=0.85
#多长时间更新续约的阈值
eureka.server.renewal-threshold-update-interval-ms=0
#对于缓存的注册数据,多长时间过期
eureka.server.response-cache-auto-expiration-in-seconds=180
#多长时间更新一次缓存中的服务注册数据
eureka.server.response-cache-update-interval-ms=0
#缓存增量数据的时间,以便在检索的时候不丢失信息
eureka.server.retention-time-in-m-s-in-delta-queue=0
#当时间戳不一致的时候,是否进行同步
eureka.server.sync-when-timestamp-differs=true
#是否采用只读缓存策略,只读策略对于缓存的数据不会过期。
eureka.server.use-read-only-response-cache=true

################server node 与 node 之间关联的配置#####################33
#发送复制数据是否在request中,总是压缩
eureka.server.enable-replicated-request-compression=false
#指示群集节点之间的复制是否应批处理以提高网络效率。
eureka.server.batch-replication=false
#允许备份到备份池的最大复制事件数量。而这个备份池负责除状态更新的其他事件。可以根据内存大小,超时和复制流量,来设置此值得大小
eureka.server.max-elements-in-peer-replication-pool=10000
#允许备份到状态备份池的最大复制事件数量
eureka.server.max-elements-in-status-replication-pool=10000
#多个服务中心相互同步信息线程的最大空闲时间
eureka.server.max-idle-thread-age-in-minutes-for-peer-replication=15
#状态同步线程的最大空闲时间
eureka.server.max-idle-thread-in-minutes-age-for-status-replication=15
#服务注册中心各个instance相互复制数据的最大线程数量
eureka.server.max-threads-for-peer-replication=20
#服务注册中心各个instance相互复制状态数据的最大线程数量
eureka.server.max-threads-for-status-replication=1
#instance之间复制数据的通信时长
eureka.server.max-time-for-replication=30000
#正常的对等服务instance最小数量。-1表示服务中心为单节点。
eureka.server.min-available-instances-for-peer-replication=-1
#instance之间相互复制开启的最小线程数量
eureka.server.min-threads-for-peer-replication=5
#instance之间用于状态复制,开启的最小线程数量
eureka.server.min-threads-for-status-replication=1
#instance之间复制数据时可以重试的次数
eureka.server.number-of-replication-retries=5
#eureka节点间间隔多长时间更新一次数据。默认10分钟。
eureka.server.peer-eureka-nodes-update-interval-ms=600000
#eureka服务状态的相互更新的时间间隔。
eureka.server.peer-eureka-status-refresh-time-interval-ms=0
#eureka对等节点间连接超时时间
eureka.server.peer-node-connect-timeout-ms=200
#eureka对等节点连接后的空闲时间
eureka.server.peer-node-connection-idle-timeout-seconds=30
#节点间的读数据连接超时时间
eureka.server.peer-node-read-timeout-ms=200
#eureka server 节点间连接的总共最大数量
eureka.server.peer-node-total-connections=1000
#eureka server 节点间连接的单机最大数量
eureka.server.peer-node-total-connections-per-host=10
#在服务节点启动时,eureka尝试获取注册信息的次数
eureka.server.registry-sync-retries=
#在服务节点启动时,eureka多次尝试获取注册信息的间隔时间
eureka.server.registry-sync-retry-wait-ms=
#当eureka server启动的时候,不能从对等节点获取instance注册信息的情况,应等待多长时间。
eureka.server.wait-time-in-ms-when-sync-empty=0

####################################################
#############    client配置           ###############
####################################################

#该客户端是否可用
eureka.client.enabled=true
#实例是否在eureka服务器上注册自己的信息以供其他服务发现,默认为true
eureka.client.register-with-eureka=false
#此客户端是否获取eureka服务器注册表上的注册信息,默认为true
eureka.client.fetch-registry=false
#是否过滤掉,非UP的实例。默认为true
eureka.client.filter-only-up-instances=true
#与Eureka注册服务中心的通信zone和url地址
eureka.client.serviceUrl.defaultZone=http://${eureka.instance.hostname}:${server.port}/eureka/

#client连接Eureka服务端后的空闲等待时间,默认为30 秒
eureka.client.eureka-connection-idle-timeout-seconds=30
#client连接eureka服务端的连接超时时间,默认为5秒
eureka.client.eureka-server-connect-timeout-seconds=5
#client对服务端的读超时时长
eureka.client.eureka-server-read-timeout-seconds=8
#client连接all eureka服务端的总连接数,默认200
eureka.client.eureka-server-total-connections=200
#client连接eureka服务端的单机连接数量,默认50
eureka.client.eureka-server-total-connections-per-host=50
#执行程序指数回退刷新的相关属性,是重试延迟的最大倍数值,默认为10
eureka.client.cache-refresh-executor-exponential-back-off-bound=10
#执行程序缓存刷新线程池的大小,默认为5
eureka.client.cache-refresh-executor-thread-pool-size=2
#心跳执行程序回退相关的属性,是重试延迟的最大倍数值,默认为10
eureka.client.heartbeat-executor-exponential-back-off-bound=10
#心跳执行程序线程池的大小,默认为5
eureka.client.heartbeat-executor-thread-pool-size=5
# 询问Eureka服务url信息变化的频率(s),默认为300秒
eureka.client.eureka-service-url-poll-interval-seconds=300
#最初复制实例信息到eureka服务器所需的时间(s),默认为40秒
eureka.client.initial-instance-info-replication-interval-seconds=40
#间隔多长时间再次复制实例信息到eureka服务器,默认为30秒
eureka.client.instance-info-replication-interval-seconds=30
#从eureka服务器注册表中获取注册信息的时间间隔(s),默认为30秒
eureka.client.registry-fetch-interval-seconds=30

# 获取实例所在的地区。默认为us-east-1
eureka.client.region=us-east-1
#实例是否使用同一zone里的eureka服务器,默认为true,理想状态下,eureka客户端与服务端是在同一zone下
eureka.client.prefer-same-zone-eureka=true
# 获取实例所在的地区下可用性的区域列表,用逗号隔开。(AWS)
eureka.client.availability-zones.china=defaultZone,defaultZone1,defaultZone2
#eureka服务注册表信息里的以逗号隔开的地区名单,如果不这样返回这些地区名单,则客户端启动将会出错。默认为null
eureka.client.fetch-remote-regions-registry=
#服务器是否能够重定向客户端请求到备份服务器。 如果设置为false,服务器将直接处理请求,如果设置为true,它可能发送HTTP重定向到客户端。默认为false
eureka.client.allow-redirects=false
#客户端数据接收
eureka.client.client-data-accept=
#增量信息是否可以提供给客户端看,默认为false
eureka.client.disable-delta=false
#eureka服务器序列化/反序列化的信息中获取"_"符号的的替换字符串。默认为"__"
eureka.client.escape-char-replacement=__
#eureka服务器序列化/反序列化的信息中获取"$"符号的替换字符串。默认为"_-"
eureka.client.dollar-replacement="_-"
#当服务端支持压缩的情况下,是否支持从服务端获取的信息进行压缩。默认为true
eureka.client.g-zip-content=true
#是否记录eureka服务器和客户端之间在注册表的信息方面的差异,默认为false
eureka.client.log-delta-diff=false
# 如果设置为true,客户端的状态更新将会点播更新到远程服务器上,默认为true
eureka.client.on-demand-update-status-change=true
#此客户端只对一个单一的VIP注册表的信息感兴趣。默认为null
eureka.client.registry-refresh-single-vip-address=
#client是否在初始化阶段强行注册到服务中心,默认为false
eureka.client.should-enforce-registration-at-init=false
#client在shutdown的时候是否显示的注销服务从服务中心,默认为true
eureka.client.should-unregister-on-shutdown=true


####################################################
#############    Instance配置         ###############
####################################################
#服务注册中心实例的主机名
eureka.instance.hostname=localhost
#注册在Eureka服务中的应用组名
eureka.instance.app-group-name=
#注册在的Eureka服务中的应用名称
eureka.instance.appname=
#该实例注册到服务中心的唯一ID
eureka.instance.instance-id=
#该实例的IP地址
eureka.instance.ip-address=
#该实例,相较于hostname是否优先使用IP
eureka.instance.prefer-ip-address=false

# 超时剔除的时间改为 9 秒,默认90s
eureka.instance.lease-expiration-duration-in-seconds=9
# 心跳间隔时间修改为 3 秒。默认30s
eureka.instance.lease-renewal-interval-in-seconds=3
2.5.REST API
| 操作 | API | 描述 |
|---|---|---|
| 注册应用实例 | POST /eureka/apps/{appId} | 输入json或xml格式的body,成功返回204 |
| 注销应用实例 | DELETE /eureka/apps/{appId}/{instanceId} | 成功返回200 |
| 应用实例发送心跳/续约 | PUT /eureka/apps/{appId}/{instanceId} | 成功返回200,如果instanceId不存在返回404 |
| 查询所有实例 | GET /eureka/apps/ | 成功返回200,输出json或xml格式。 |
| 查询指定appId实例 | GET /eureka/apps/{appId} | 成功返回200,输出json或xml格式。 |
| 查询指定appId和instanceId | GET /eureka/apps/{appId}/{instanceId} | 成功返回200,输出json或xml格式。 |
| 查询指定instanceId | GET /eureka/instances/{instanceId} | 成功返回200,输出json或xml格式。 |
| 暂停应用实例 | PUT /eureka/apps/{appId}/{instanceId}/status?value=OUT_OF_SERVICE | 成功返回200,失败返回500。 |
| 恢复应用实例 | DELETE /eureka/apps/{appId}/{instanceId}/status?value=UP | 成功返回200,失败返回500 |
| 更新元数据 | PUT /eureka/apps/{appId}/{instanceId}/metadata?key=value | 成功返回200,失败返回500 |
| 根据vip地址查询 | GET /eureka/vips/{appId}/{vipAddress} | 成功返回200,输出json或xml格式。 |
| 根据svip地址查询 | GET /eureka/svips/{appId}/{svipAddress} | 成功返回200,输出json或xml格式。 |
| 增量查询注册表 | GET /eureka/apps/delta | 成功返回200,输出json或xml格式。 |
注册实例请求案例
- PS:设置请求参数的类型为JSON。否则默认接受XML格式的请求。Accept:application/json
- PS:如果server开启了security,就要设置请求头:Authorization:Basic cm9vdDpzRkFJZDcyaw== 。后面的内容就是 base64(账号:密码)
curl --location --request POST 'http://127.0.0.1:9001/eureka/apps/OPENFEIGN-PROVIDER' \
--header 'Accept: application/json' \
--header 'Content-Type: application/json' \
--data-raw '{
    "instance": {
        "instanceId": "zhangxue07-phq-PC:TEST-8007:8007",
        "hostName": "127.0.0.1",
        "app": "TEST-8007",
        "ipAddr": "127.0.0.1",
        "status": "UP",
        "overriddenStatus": "UNKNOWN",
        "port": {
            "$": 8007,
            "@enabled": "true"
        },
        "securePort": {
            "$": 443,
            "@enabled": "false"
        },
        "countryId": 1,
        "dataCenterInfo": {
            "@class": "com.netflix.appinfo.InstanceInfo$DefaultDataCenterInfo",
            "name": "MyOwn"
        },
        "leaseInfo": {
            "renewalIntervalInSecs": 30,
            "durationInSecs": 90,
            "registrationTimestamp": 1672748297041,
            "lastRenewalTimestamp": 1672748297041,
            "evictionTimestamp": 0,
            "serviceUpTimestamp": 1672748297041
        },
        "metadata": {
            "management.port": "8007"
        },
        "homePageUrl": "http://127.0.0.1:8007/",
        "statusPageUrl": "http://127.0.0.1:8007/actuator/info",
        "healthCheckUrl": "http://127.0.0.1:8007/actuator/health",
        "vipAddress": "TEST-8007",
        "secureVipAddress": "TEST-8007",
        "isCoordinatingDiscoveryServer": "false",
        "lastUpdatedTimestamp": "1672748297041",
        "lastDirtyTimestamp": "1672748296432",
        "actionType": "ADDED"
    }
}'
3.原理
3.1.客户端负载及故障转移
- 客户端负载。应用启动时以应用ip作为随机因子,随机打乱eureka的顺序,并连接第一个节点。
- 故障转移。当出现节点异常时,也是异常访问重试2次任然失败后,依次连线列表中的eureka,实现故障的转移。
3.2.三级缓存机制
- registry,一级缓存,核心注册表,数据来源:服务注册/续约/下线等实时更新。UI界面直接使用registry;
- 类型:ConcurrentHashMap<String, Map<String, Lease
>> - 实现类:AbstractInstanceRegistry
- 类型:ConcurrentHashMap<String, Map<String, Lease
- ReadWriteCacheMap,二级缓存,缓存时间180秒,缓存失效后,从一级缓存中同步数据更新。
- 类型:LoadingCache<Key, Value>
- 实现类:ResponseCacheImpl
- ReadOnlyCacheMap,三级缓存,客户端缓存,Eureka Client查询时生成,默认每30s。通过定时任务轮询判断是否需要移除缓存。
- 类型:ConcurrentMap<Key, Value>
- 实现类:ResponseCacheImpl
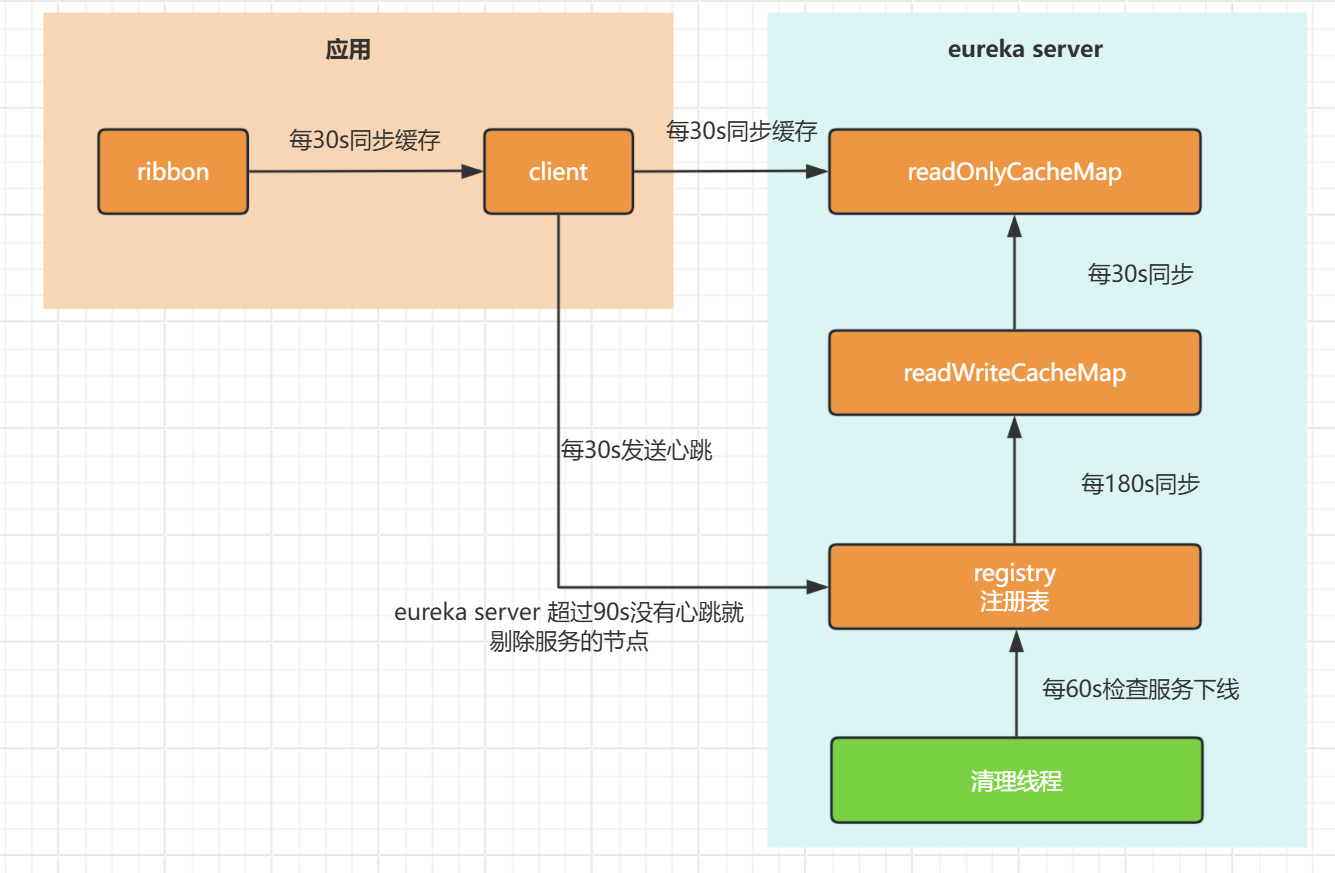
缓存读取流程
ResponseCacheImpl.java
Value getValue(final Key key, boolean useReadOnlyCache) {
  Value payload = null;
  try {
      // 1、是否开启三级缓存
      if (useReadOnlyCache) {
          // 1.1、先从三级缓存中获取,如果不存在再从二级缓存中获取
          final Value currentPayload = readOnlyCacheMap.get(key);
          if (currentPayload != null) {
              payload = currentPayload;
          } else {
              // 1.2、三级缓存不存在,则从二级缓存中获取,并保存到三级缓存中
              payload = readWriteCacheMap.get(key);
              readOnlyCacheMap.put(key, payload);
          }
      } else {
          // 2、未开启三级缓存,直接从二级缓存中获取
          payload = readWriteCacheMap.get(key);
      }
      // 3、这里隐藏了一层查询。如果二级缓存未命中,则调用LoadingCache的build方法,从一级缓存中查询数据,并保存到二级缓存中。
  } catch (Throwable t) {
      logger.error("Cannot get value for key : {}", key, t);
  }
  return payload;
}
为什么使用三级缓存?
先看下缓存的数据是什么
public class Value {
    private final String payload; // 序列化为json的应用级数据(不是实例级别的)
    private byte[] gzipped;       // 压缩后的json数据(不是实例级别的)
}
因为客户端查询数据,需要对数据进行序列化,当Eureka注册应用实例数量到达10~30K,就会导致客户端与服务端频繁的序列化与反序列化, 造成不必要的CPU消耗,所以采用缓存序列化好的数据,降低频繁序列化的资源消耗,提升并发处理能力。 同时也降低并发读写时带来的频繁的锁竞争,所以采用了类似于读取分离的设计。
如果优化客户端发现延迟?
Eureka服务发现的速度其实是比较慢的,这也是ap模型的通病。
默认配置下延迟计算:
- 客户端获得实例变化存在延迟,极端情况可能是:30(ribbon更新)+30(客户端拉取)+30(三级缓存更新)+180(二级缓存更新) = 270s。
- 如果被调用方没有使用平滑升级(被动剔除服务),极端情况可能是:270(上面基础)+ 60 * 2(两次主动清除下线90s没有心跳的实例)= 390s。
服务端优化
- eureka.server.useReadOnlyResponseCache=false。关闭三级缓存,直接读取ReadWriteCacheMap
- eureka.server.responseCacheUpdateIntervalMs。二级缓存更新时间,默认180s,可以降低到10s
- eureka.server.eviction-interval-timer-in-ms。清除失效服务的间隔时间,默认60s,可以降低到10s。
- eureka.instance.lease-expiration-duration-in-seconds。服务续约到期时间,默认90s。降低到65s。 客户端每30s续约一次,90s是3次未续约,可以降为2次,防止客户端采用默认配置导致服务经常被剔除。
客户端优化:
- eureka.client.registry-fetch-interval-seconds。从eureka服务器注册表中获取注册信息的时间间隔(s),默认为30秒,可以降低到10s。
经过以上优化,极端情况下延迟:10(ribbon更新)+10(客户端拉取)+10(二级缓存更新) + 7 * 10(两次主动清除下线65s没有心跳的应用)= 100s。
除此之外还有非常多的参数都可以进行优化,但是要根据自身情况,并且无论进行怎么优化,延迟都是存在的。
二次开发可优化点?
- 关闭三级缓存后。增加一个队列,每次当注册表发生变化的时候,将变化的数据放到队列中,开始一个任务线程,读取队列数据,同步到二级缓存中,实现准实时更新。
- 优化客户端拉取注册表。增加项目维度的管理工具,每次值拉取已经订阅的项目列表,减少无效数据的拉取。
3.3.数据同步机制
集群节点之间数据一致性是通过节点之间数据同步来实现的,数据同步采用的是Acceptor - Worker 模式的消息广播机制来完成的,整个过程大致就是:
- 某个节点收到客户端的消息(注册、心跳、下线、状态变更等)后,刷新本地注册信息(这里调用已经返回成功,下面步骤采用异步的方式进行);
- 遍历所有的节点(会排除自己),将消息转发到其他节点;
数据同步方式?
分为全量同步与增量同步。全量同步为客户端第一次启动时进行的,增量同步为运行过程中进行的。
同步核心逻辑:PeerAwareInstanceRegistryImpl#replicateToPeers
private void replicateToPeers(Action action, InstanceInfo instanceInfo, boolean isReplication) {
    if (isReplication) {
        // 避免重复同步(若当前操作本身来自其他节点的同步)
        return;
    }
    // 获取所有peer节点,向每个节点发送同步任务
    for (final PeerEurekaNode node : peerEurekaNodes.getPeerEurekaNodes()) {
        replicateInstanceActionsToPeers(action, instanceInfo, node);
    }
}
触发时机:当接口接受请求时同步调用。 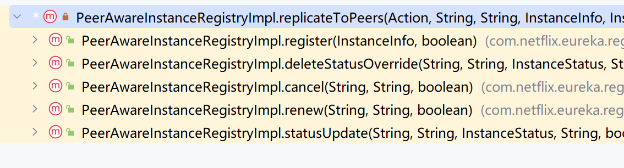
如何避免死循环?
假如:客户端对服务端A进行了下线操作,服务端A将操作同步到B、C、D其他3个服务端,当服务端B接收到同步过来的下线请求后, 会不会再将该操作又同步到其他的服务端,从而使同步陷入死循环呢?
答案是不会,Eureka会区分正常的客户端请求与服务端发起的数据同步请求,对于任何服务端发起的数据同步请求,Eureka不会再进行其他同步操作,从而避免数据同步出现死循环。
具体的做法是Eureka在http请求头中加入特殊的标识(x-netflix-discovery-replication),用来区分正常的客户端请求与数据同步请求。
如何解决数据冲突?
- 使用版本号解决数据冲突。一般我们给数据加一个版本号就行,如时间戳,只要有任何数据更新操作,就更新时间戳,最后更新数据的时间戳最大, 也就是最新的数据,上面讲Eureka中注册表中时间信息就是做此用途的。
- 客户端主动通过拉取服务端注册表数据,如果发现与本地数据存在冲突,则让有冲突的客户端从新执行注册操作
3.4.服务启动
使用@EnableEurekaServer作为标记。
@Import(EurekaServerMarkerConfiguration.class)
public @interface EnableEurekaServer {  }
springboot启动的时候,加载注解,发现了@import一个类EurekaServerMarkerConfiguration。
public class EurekaServerMarkerConfiguration {
	@Bean
	public Marker eurekaServerMarkerBean() {
		return new Marker();
	}
	class Marker { }
}
我们发现这里只是创建了一个Marker对象。通过阅读注释发现,springcloud eureka使用spring.factories中有个自动配置类。 启动条件为存在Marker的对象。这是一个spring config类,在spring启动过程会调用相关方法。
@Import(EurekaServerInitializerConfiguration.class)
@ConditionalOnBean(EurekaServerMarkerConfiguration.Marker.class)
public class EurekaServerAutoConfiguration implements WebMvcConfigurer {   }
这个过程中会使用@Bean实例化很多个对象。这些了都似乎eureka本身的类。
- PeerAwareInstanceRegistry。eureka的注册表对象的实例
- PeerEurekaNodes。管理Eureka Server集群中的节点信息,确保节点之间能够相互复制数据。
- EurekaServerContext。维护 Eureka Server 启动的上下文信息,主要工作时启动服务
- EurekaServerBootstrap。负责初始化Eureka Server的环境变量与上下文。
- javax.ws.rs.core.Application。启动jersey,和spring mvc一样的restfull框架。用来单独暴露一些接口。
服务启动。初始化EurekaServerContext接口的实现类DefaultEurekaServerContext
@Singleton
public class DefaultEurekaServerContext implements EurekaServerContext {
    @PostConstruct
    public void initialize() {
        logger.info("Initializing ...");
        peerEurekaNodes.start();          // 服务启动,调用PeerEurekaNodes
        registry.init(peerEurekaNodes);   // 初始化注册表。调用PeerAwareInstanceRegistry
        logger.info("Initialized");
    }
    @PreDestroy // 注册优雅关机
    public void shutdown() {
        logger.info("Shutting down ...");
        registry.shutdown();
        peerEurekaNodes.shutdown();
        ServoControl.shutdown();
        EurekaMonitors.shutdown();
        logger.info("Shut down");
    }
}
3.5.客户端启动
客户端启动时,主要是读取配置、注册服务(可以不注册)、启动健康检查、启动定时查询增量注册表任务、启动定时续约心跳任务等。
核心组件:com.netflix.discovery.DiscoveryClient。主要用于与Eureka服务注册中心进行交互,所有的核心逻辑都在这里。
- 服务注册(Service Registration):服务启动时,向Eureka Server注册自己,包括服务的元数据信息(如服务名、IP地址、端口号、健康检查URL等)。
- 服务发现(Service Discovery):服务消费者在调用服务时,会先通过DiscoveryClient向Eureka Server发送查询请求,获取到所有可用的服务提供者(Provider)的地址列表。 然后,服务消费者会根据负载均衡策略(如Ribbon),从列表中选择一个服务提供者进行调用。
- 健康检查(Health Check):定期向Eureka Server发送心跳(Heartbeat),实现注册的续约逻辑。
- 元数据管理(Metadata Management):服务的元数据信息(如版本、环境等)会随服务注册时一起提交给Eureka Server,并可以通过DiscoveryClient进行更新。其他服务在发现该服务时,可以通过元数据信息进行路由、负载均衡决策等。
- 服务状态变更通知(Service Status Change Notifications):同时获得服务状态,如果发生变化(如上线、下线、故障等)时,Eureka Server会将这些变更信息推送给所有订阅了该服务状态的客户端。
3.5.1.启动流程
@EurekaClientEnable 高版本中已经没有作用了。Eureka客户端启动 会自动加载 spring.factories 中的 EurekaClientAutoConfiguration 和 EurekaDiscoveryClientConfiguration。
作用是读取配置文件,创建客户端相关组件。
- EurekaClientAutoConfiguration#eurekaInstanceConfigBean()。读取配置文件,将配置封装为 EurekaInstanceConfigBean。
- EurekaClientAutoConfiguration#eurekaApplicationInfoManager()。创建客户端应用实例信息管理器 ApplicationInfoManager。
- 内部维护 EurekaInstanceConfigBean 和 InstanceInfo等信息。
- ApplicationInfoManager实例全局唯一,这也是为什么eureka一个客户端服务,同时只能连接一个eureka server的原因。
- 内部维护客户端实例状态,如果状态变更就发送事件 StatusChangeEvent。
- EurekaDiscoveryClientConfiguration#discoveryClient。创建客户端实例 EurekaDiscoveryClient。
- EurekaDiscoveryClient是spring提供的客户端,功能很少,主要作用是代理netflix提供的DiscoveryClient。
- EurekaClientAutoConfiguration#eurekaAutoServiceRegistration。上面4个组件创建完成后,创建自动注册实例EurekaAutoServiceRegistration。
1~4都是创建对象。核心对象是EurekaAutoServiceRegistration,他现了SmartApplicationListener,接收spring两种事件:
- WebServerInitializedEvent。web服务初始化完成事件,执行EurekaAutoServiceRegistration#start()
- ContextClosedEvent。服务关闭事件,执行EurekaAutoServiceRegistration#stop()。取消注册、发送事件InstanceStatus.DOWN。
EurekaAutoServiceRegistration#start() 调用链: -> EurekaServiceRegistry#register -> DiscoveryClient#registerHealthCheck -> InstanceInfoReplicator#onDemandUpdate -> InstanceInfoReplicator#run
InstanceInfoReplicator#run是核心逻辑:
- 调用discoveryClient.refreshInstanceInfo 刷新实例信息
- 调用discoveryClient.register 进行注册
- 调用sheduler.shedule 30s后再执行run方法。
3.5.2.健康检查
InstanceInfoReplicator#run中核心逻辑就是监控检查,默认30s执行一次。
为什么要定时检查吗?
- 因为本服务的信息可能发生变化,需要定期检查,并重新注册到注册中心上。例如数据中心、服务名称、ip地址、续期相关配置等
- 健康检查。检查本服务是否正常,如果存在问题,会自动取消注册信息,防止问题节点被别人调用到。
HealthCheckHandler 提供了两个实现类。
- HealthCheckCallbackToHandlerBridge。默认采用。就是判断下本地实例的状态值。
- EurekaHealthCheckHandler。如果引入actuator组件会引入配置类,自动注入EurekaHealthCheckHandler。
加载过程:EurekaClientAutoConfiguration自动配置
@ConditionalOnClass(Health.class) //org.springframework.boot.actuate.health.Health
protected static class EurekaHealthIndicatorConfiguration {
    @Bean
    @ConditionalOnEnabledHealthIndicator("eureka")
    public EurekaHealthIndicator eurekaHealthIndicator(EurekaClient eurekaClient,
            EurekaInstanceConfig instanceConfig, EurekaClientConfig clientConfig) {
        return new EurekaHealthIndicator(eurekaClient, instanceConfig, clientConfig);
    }
}
EurekaHealthCheckHandler 是springcloud提供的,会从spring中查询所有actuator提供的HealthIndicator实例, 内置了很多约27个 HealthIndicator(包括:数据库、网络、磁盘等各种检查工具),一旦这些指标出现问题,客户端就会取消注册。
说白了就是使用actuator的监控数据进行判断。
数据库异常导致eureka注销问题排查 Eureka-client定时通过所有的HealthIndicator的health方法获取对应的健康检查状态,如果有HealthIndicator检测结果为DOWN, 那Eureka-client就会判定当前服务有问题,是不可用的,就会将自身状态设置为DOWN,并上报给Eureka-server。 Eureka-server收到信息之后将该节点状态标识为DOWN,这样其他服务就无法从Eureka-server获取到该节点。
3.5.3.服务发现与续约
启动过程中实例化EurekaDiscoveryClient的时候,他是DiscoveryClient的代理对象。 而spring 将 netflix 提供的 DiscoveryClient 封装为 CloudEurekaClient。保存到EurekaDiscoveryClient中。
DiscoveryClient在实例化的时候,会创建2个定时任务。
- HeartbeatExecutor 心跳/续约。 核心类 HeartbeatThread,每30s调用一次DiscoveryClient#renew。
- CacheRefreshExecutor 注册表缓存刷新。核心类 CacheRefreshThread,每30s调用一次DiscoveryClient#refreshRegistry。 根据条件有全量更新(/eureka/apps/) 和 增量更新(/eureka/apps/delta)两种。
增量更新:
- /eureka/apps/delta 接口是 Eureka 服务注册与发现框架中的一个重要接口,它主要用于提供服务的增量更新信息。
- Eureka server 会提供近期注册表发生变化(比如有新的服务实例注册、服务实例下线、服务实例的元数据或状态发生变化等)的增量数据。
- 这个数据包只包含自上次查询以来发生变化的那些服务实例的信息,而不是整个注册表的完整副本。
- 目的:这样做的好处是显著减少了数据传输量,尤其是在服务实例数量庞大且频繁变化的场景下,能够有效降低网络带宽的消耗和客户端的处理压力。
全量更新
- 服务启动时全量更新
- 如果客户端在一段时间内没有收到任何增量更新,或者由于某种原因(如网络问题)错过了增量更新。
4.最佳实践
4.1.注意事项
- 优雅停服:客户端如果使用kill -9,注册表被动发现心跳检查超时才下线服务,加大了调用方感知服务下线的时间。所以客户端需要使用优雅停服,帮助应用正常被下线。可以使用 actator 的shutdown接口
- 密码认证:使用spring-boot-starter-security。也是基于base auth的简单认证。
- 注册表隔离。需要二次开发,推进规范化命令,比如:系统名称-模块名称-运行环境。参数之间以中划线隔离,例如:myProject-myModel-dev
- 租户:因为eureka天然的对应用的隔离性支持的不好,没有租户的概念。我们基于 spring-boot-starter-security 扩展用户认证。实现简单的多租户 使用Spring Security实现单点登录
4.2.优雅停服
客户端使用 actuator,好处是主动注销实例,提升实例下线速度。 但是actuator中的漏洞较多,很多公司可能不会安装。所以可以自定义服务注销代码,当服务接收到停止信号的时候触发。
1.maven坐标
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-actuator</artifactId>
</dependency>

2.配置信息
###### 优雅停服######
##启用 shutdown
management.endpoint.shutdown.enabled=true
# 暴露所有端点
management.endpoints.web.exposure.include=*
#禁用密码验证
management.endpoints.shutdown.sensitive=false

3.post调用:http://127.0.0.1:9080/actuator/shutdown
4.3.密码认证
1.maven坐标
<dependency>
  <groupId>org.springframework.boot</groupId>
  <artifactId>spring-boot-starter-security</artifactId>
</dependency>

2.Eureka Server配置
#开启 http basic 的安全认证 没有用 需要通过下面方法来关闭或开启
#spring.security.basic.enabled=true
spring.security.user.name=user
spring.security.user.password=123456
 # 修改访问集群节点的 url
eureka.client.serviceUrl.defaultZone=http://user:123456@eureka2:8761/eureka/

3.客户端配置
spring.application.name=eureka-provider
server.port=9090
#设置服务注册中心地址, 指向另一个注册中心
eureka.client.serviceUrl.defaultZone=http://user:123456@eureka1:8761/eureka/,http://user:123456@eureka2:8761/eureka/
#启用 shutdown
management.endpoints.shutdown.enabled=true
#禁用密码验证
management.endpoints.shutdown.sensitive=false

4.关闭csrf认证
Spring Cloud 2.0 以上的security默认启用了csrf检验,要在eurekaServer端配置security的csrf检验为false

@EnableWebSecurity
@Configuration
public class WebSecurityConfig extends WebSecurityConfigurerAdapter {
    @Override
    protected void configure(HttpSecurity http) throws Exception {
        http.csrf().disable(); //关闭csrf
        //开启认证  若注释掉,就关闭认证了
        http.authorizeRequests().anyRequest().authenticated().and().httpBasic();
    }
}
4.4.实例ID
# 推荐使用ip:port。默认规则 机器hostname:应用名称:端口
eureka.instance.instance-id = ${spring.cloud.client.ip-address}:${server.port}
4.5.性能优化
eureka是去中心化的,对等星型同步架构,ap模型。所以对于每次变更(注册/心跳续约/状态变更等)都会生成相应的同步任务来用于所有实例数据的同步, 这样一来同步作业量随着集群规模、实例数正相关同步上涨。 如果集群里注册的服务实例数过万,可能出现CPU占用率、负载都很高,时不时还会发生 Full GC 导致业务抖动。
再加上eureka的二级队列发布模型,很容易造成同步队列任务积压,加剧服务发现的延迟,如果再遇到网络抖动,导致客户端切换eureka节点,就会引发同步任务的重试风暴,性能直接爆炸。
eureka官方提到:Eureka 的这种广播复制模型,不仅会导致它自身的架构脆弱性,也影响了集群整体的横向扩展性。
4.6.自我保护机制
4.6.1.自我保护条件
- 自我保护的条件: 一般情况下, 微服务在Eureka上注册后, 会每30秒发送心跳包,Eureka通过心跳来判断服务是否健康, 同时会定期删除超过90秒没有发送心跳服务。
- 触发阀值:Eureka Server 在运行期间,会统计心跳失败的比例在 15 分钟内是否低于 85%这种算法叫做 Eureka Server 的自我保护模式
Eureka Server收不到微服务的心跳:
- 微服务自身的原因
- 大规模服务上下线。
- 网络故障,通常(微服务的自身的故障关闭)只会导致个别服务出现故障, 一般不会出现大面积故障, 而(网络故障)通常会导致Eureka Server在短时间内无法收到大批心跳。
考虑到这个区别,Eureka设置了一个阀值, 当判断挂掉的服务的数量超过阀值时,Eureka Server 认为很大程度上出现了网络故障, 将不再删除心跳过期的服务。
4.6.2.为什么需要自我保护
- 因为同时保留好数据与坏数据总比丢掉任何数据要更好, 当网络故障恢复后,这个 Eureka节点会退出自我保护模式。
- Eureka还有客户端缓存功能(也就是微服务的缓存功能)。 即便 Eureka 集群中所有节点都宕机失效, 微服务的 Provider 和 Consumer都能正常通信。
- 微服务的负载均衡策略会自动剔除死亡的微服务节点
4.6.3.关闭自我保护【不建议】
注册应用数量非常小,不建议开启。例如注册服务本身就3个,服务重启就会进入保护模式。
#关闭自我保护:true 为开启自我保护, false 为关闭自我保护
eureka.server.enableSelfPreservation=false

## 自我保护触发的阈值,可以适当修改
eureka.server.renewal-percent-threshold: 0.85

#清理间隔(从服务列表删除无用服务的时间间隔,单位:毫秒, 默认是 60*1000)
eureka.server.eviction.interval-timer-in-ms=60000
4.7.监控指标
eureka并未提供监控指标,需要通过自定义指标来实现。并且grafana也没有监控面板,需要我们自己定义。
<!-- 普罗米修斯监控 -->
<!-- springboot内置收集系统数据功能包 -->
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-actuator</artifactId>
</dependency>
<!-- prometheus收集数据功能包 -->
<dependency>
    <groupId>io.micrometer</groupId>
    <artifactId>micrometer-registry-prometheus</artifactId>
</dependency>


###### 开启指标 ######
management:
  # 暴露所有端点
  endpoints:
    web:
      exposure:
        include: '*'
  # http://localhost:8080/actuator/prometheus
  metrics:
    export:
      prometheus:
        enabled: true
        descriptions: true

###### 自定义指标 ######
@Configuration
public class EurekaConfig {

    // 示例:统计注册服务数量
    @Bean
    public MeterBinder registeredServicesCounter(EurekaClient eurekaClient) {
        return registry -> {
            Counter counter = Counter.builder("eureka.registered_services")
                    .description("Number of registered services")
                    .register(registry);
            Applications applications = eurekaClient.getApplications();
            counter.increment(applications.size());
        };
    }
}
可以自定义的指标包括
- 服务注册与实例状态指标
- eureka_server_instance_counts{status="UP"}:状态为UP的服务实例数量(核心指标,反映健康服务数量)。
- eureka_server_instance_counts{status="DOWN"}:状态为DOWN的服务实例数量(异常服务监控)。
- eureka_server_instance_counts{status="STARTING"}:处于启动中状态的服务实例数量。
- 注册中心集群同步指标
- eureka_server_peer_replication_events_total:Eureka集群节点间的复制事件总数(反映集群数据同步频率)。
- eureka_server_peer_replication_failures_total:集群复制失败次数(监控集群一致性问题)。
- 服务续约与下线指标
- eureka_server_renewal_rate:服务续约成功率(正常应接近1.0,低于阈值可能有服务异常)。
- eureka_server_evictions_total:因未续约被剔除的服务实例总数(异常增长可能意味着服务稳定性问题)。
- Eureka Server自身性能指标
- jvm_memory_used_bytes:Eureka Server的JVM内存使用量(监控内存泄漏)。
- http_server_requests_seconds_count{uri="/eureka/apps"}:服务注册/查询接口的请求次数(反映Eureka的负载)。
- process_cpu_usage:Eureka Server的CPU使用率(监控服务器负载)。
- 本文作者:zhangxue
- 本文链接:https://lucksnow1989.github.io/article/8.微服务/3.注册中心&配置中心/Eureka.html
- 版权声明:本文为本人原创文章,遵循 CC 4.0 BY-NC-SA版权协议,转载请附上原文出处链接和本声明。