 张雪随笔
3.k8s
- Kubernetes面试题超详细总结:https://mp.weixin.qq.com/s/1qsLwI_f3KUljx2mi7osAw
- Docker 不香吗,为啥还要 K8s?:https://mp.weixin.qq.com/s/YGLKTkl7D2baM_VsZiZFww
- 带你快速了解 Docker 和 Kubernetes:https://mp.weixin.qq.com/s/KLuMQj4y1gaHLCsdTbToDA
- springboot + nacos + k8s 优雅停机
介绍
1.基础
K8s是由Google发起的CNCF出品的容器编排工具。
服务治理:service mesh 概念目前非常新,还在发展中,主要的代表作为istio,linkerd等
核心特性
- 服务发现与负载均衡:无需修改你的应用程序即可使用陌生的服务发现机制。
- 存储编排:自动挂载所选存储系统,包括本地存储。
- Secret和配置管理:部署更新Secrets和应用程序的配置时不必重新构建容器镜像,且不必将软件堆栈配置中的秘密信息暴露出来。
- 批量执行:除了服务之外,Kubernetes还可以管理你的批处理和CI工作负载,在期望时替换掉失效的容器。
- 水平扩缩:使用一个简单的命令、一个UI或基于CPU使用情况自动对应用程序进行扩缩。
- 自动化上线和回滚:Kubernetes会分步骤地将针对应用或其配置的更改上线,同时监视应用程序运行状况以确保你不会同时终止所有实例。
- 自动装箱:根据资源需求和其他约束自动放置容器,同时避免影响可用性。
- 自我修复:重新启动失败的容器,在节点死亡时替换并重新调度容器,杀死不响应用户定义的健康检查的容器。
2.被放弃的Docker
Docker是国内绝大部分人接触容器学习的第一个工具,但是K8s从1.24开始移除了docker,原因:
- k8s为了操作pod,制定了一套CRI标准,而docker并没有实现这套标准且不打算实现。(两家公司对标准的竞争,显然docker输了)
- 由于docker出现的早,市场占比大,所有k8s初期为了兼容docker,增加了一层接口的转换。导致k8s操作docker的性能较差。
- 现在k8s的市场已经很大,且已经有很多和docker一样优秀的容器化工具,比如containerd、CRI-O、podman等。
如今使用k8s正式推荐使用Google自研的podman。
- Podman的定位是从用户使用上完全兼容docker(操作命令与docker一样)
- Docker的市场已经是昨日黄花。
3.容器化的挑战
DevOps 团队挑战:
- 复杂的集群操作和维护
- 跟上快速的平台演进
- 大规模管理安全和合规性
- 故障排查分布式系统
应用团队挑战:
- 理解 Kubernetes 概念和架构
- 编写有效的部署配置
- 调试容器化环境中的应用问题
- 优化资源使用和成本
4.安装
不同的部署方式,适合的场景完全不一样。
- 本地快速体验:Minikube / kind / k3s
- 适用场景:个人学习、开发环境、功能验证。
- 优点:一键启动,资源占用少,快速体验 Kubernetes 全流程。
- 缺点:不适合生产,不支持大规模扩展。
- 标准生产环境:kubeadm
- 适用场景:中小型企业、想要完全掌控集群。
- 优点:官方推荐方式,灵活可控,适合学习生产级部署。
- 缺点:升级、运维成本较高,需要具备 Kubernetes 基础和运维经验。
- 典型人群:中小团队运维、想打磨 K8s 运维能力的人。
- 轻量化生产环境:k3s
- 适用场景:边缘计算、物联网、小型业务系统。
- 优点:占用少,安装快,兼容 Kubernetes API。使用containerd管理容器而非docker。
- 缺点:功能简化,不适合复杂的企业级场景。
- 典型人群:IoT 开发者、小团队项目。
- 云厂商托管版:ACK / GKE / EKS
- 适用场景:企业生产环境,尤其是对稳定性要求高的核心业务。
- 优点:免运维、弹性扩展、自动升级,省时省心。
- 缺点:厂商绑定严重,费用较高,对多云/混合云支持有限。
- 典型人群:中大型企业、没有太多运维人力的团队。
- 企业级平台:OpenShift / Rancher
- 适用场景:大型企业、DevOps 一体化、强安全合规要求。
- 优点:功能全面,CI/CD、监控、权限管理都集成好。
- 缺点:复杂度高、学习成本大、License 或商用成本高。
- 典型人群:金融、电信、制造业大厂。
5.快速安装
基于k3s单机安装K8S
硬件:至少 1 核 CPU、512 MB RAM(推荐 2 核、1 GB RAM);使用 SSD 磁盘以优化性能。
操作系统:K3s 支持大多数现代 Linux,包括 RHEL 衍生版。
网络:确保端口 6443(Kubernetes API)开放;所有出站流量允许。
权限:使用 root 或 sudo 执行命令。

1. 单机安装:K3s 包含所有必要组件,无需额外节点即可运行工作负载。)
安装命令:(默认使用containerd)
curl -sfL https://rancher-mirror.rancher.cn/k3s/k3s-install.sh |INSTALL_K3S_MIRROR=cn sh -

【推荐】不使用containerd,使用docker:因为docker的镜像仓库都是现成的不用重新配置了
curl -sfL https://rancher-mirror.rancher.cn/k3s/k3s-install.sh |INSTALL_K3S_MIRROR=cn sh -s - --docker

校验:输出应显示节点为Ready状态。
sudo kubectl get nodes

kubeconfig 文件位于 /etc/rancher/k3s/k3s.yaml,kubectl 会自动使用它。

卸载:
/usr/local/bin/k3s-uninstall.sh


2. 集群安装:集群节点执行以下命令
主节点安装:
token:curl -sfL https://rancher-mirror.rancher.cn/k3s/k3s-install.sh |INSTALL_K3S_MIRROR=cn sh -

主节点获得token:输出类似 K10abc...::server:def... 的字符串,记下作为 TOKEN。
sudo cat /var/lib/rancher/k3s/server/node-token

从节点安装:替换下面命令中的 TOKEN 为上一步获取的值。
curl -sfL https://rancher-mirror.rancher.cn/k3s/k3s-install.sh |INSTALL_K3S_MIRROR=cn K3S_URL=https://192.168.31.210:6443 K3S_TOKEN=TOKEN sh -

验证:主节点运行可以看到所有节点。
sudo kubectl get nodes

卸载集群
主节点:/usr/local/bin/k3s-uninstall.sh
节点:/usr/local/bin/k3s-agent-uninstall.sh


常见问题:
问题1:CoreDNS 无法启动并报错 Listen: listen tcp :53: bind: permission denied
# 1. 编辑 CoreDNS Deployment
sudo kubectl -n kube-system edit deployment coredns

# 2. 添加 securityContext
# 在 `spec.template.spec` 下添加:
# securityContext:
#   runAsUser: 0  # root
#   capabilities:
#     add: ["NET_BIND_SERVICE"]  # 允许绑定低端口

# 3. 重启 CoreDNS
sudo kubectl -n kube-system rollout restart deployment coredns


问题2:k3s默认使用了 traefik 代替ingress,建议删除所有traefik相关组件。
图形化界面:
kuboard:https://www.kuboard.cn/v4/install/quickstart.html
使用docker compose安装。
6.常用命令
1. 集群管理:
列出集群所有节点:kubectl get nodes
查看某个节点的详细信息: kubectl describe node <node-name>
查看使用docker还是Containerd: kubectl describe node <node-name> | grep "Container Runtime Version"
7.容器架构
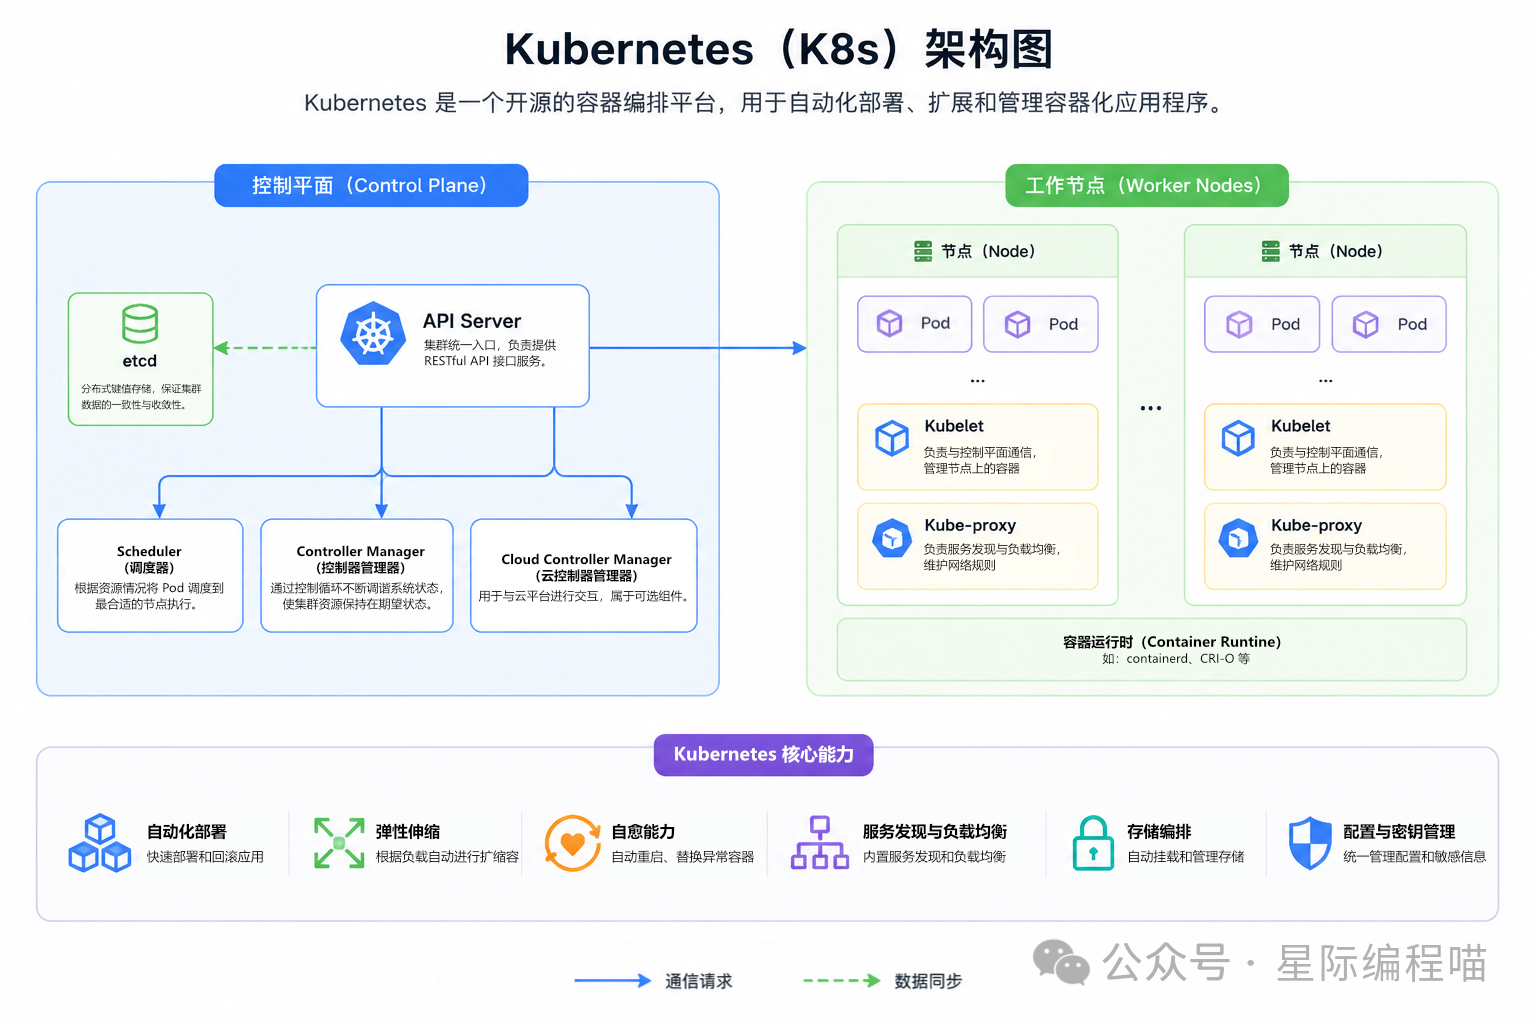
快速理解
- 基本组件
- 思维模型
- 资源概念
- 核心API
- CLI
1. 基本组件
K8S 是属于Master-Worker架构,Master 节点负责核心的调度、管理和运维,Worker 节点则执行用户的程序。 主节点一般被称为Master Node,而从节点则被称为Worker Node 或者 Node。
注意:Master Node 和 Worker Node 是分别安装了 K8S 的 Master 和 Woker 组件的实体服务器, 每个 Node 都对应了一台实体服务器(虽然 Master Node 可以和其中一个 Worker Node 安装在同一台服务器,但是建议 Master Node 单独部署), 所有 Master Node 和 Worker Node 组成了 K8S 集群,同一个集群可能存在多个 Master Node 和 Worker Node。
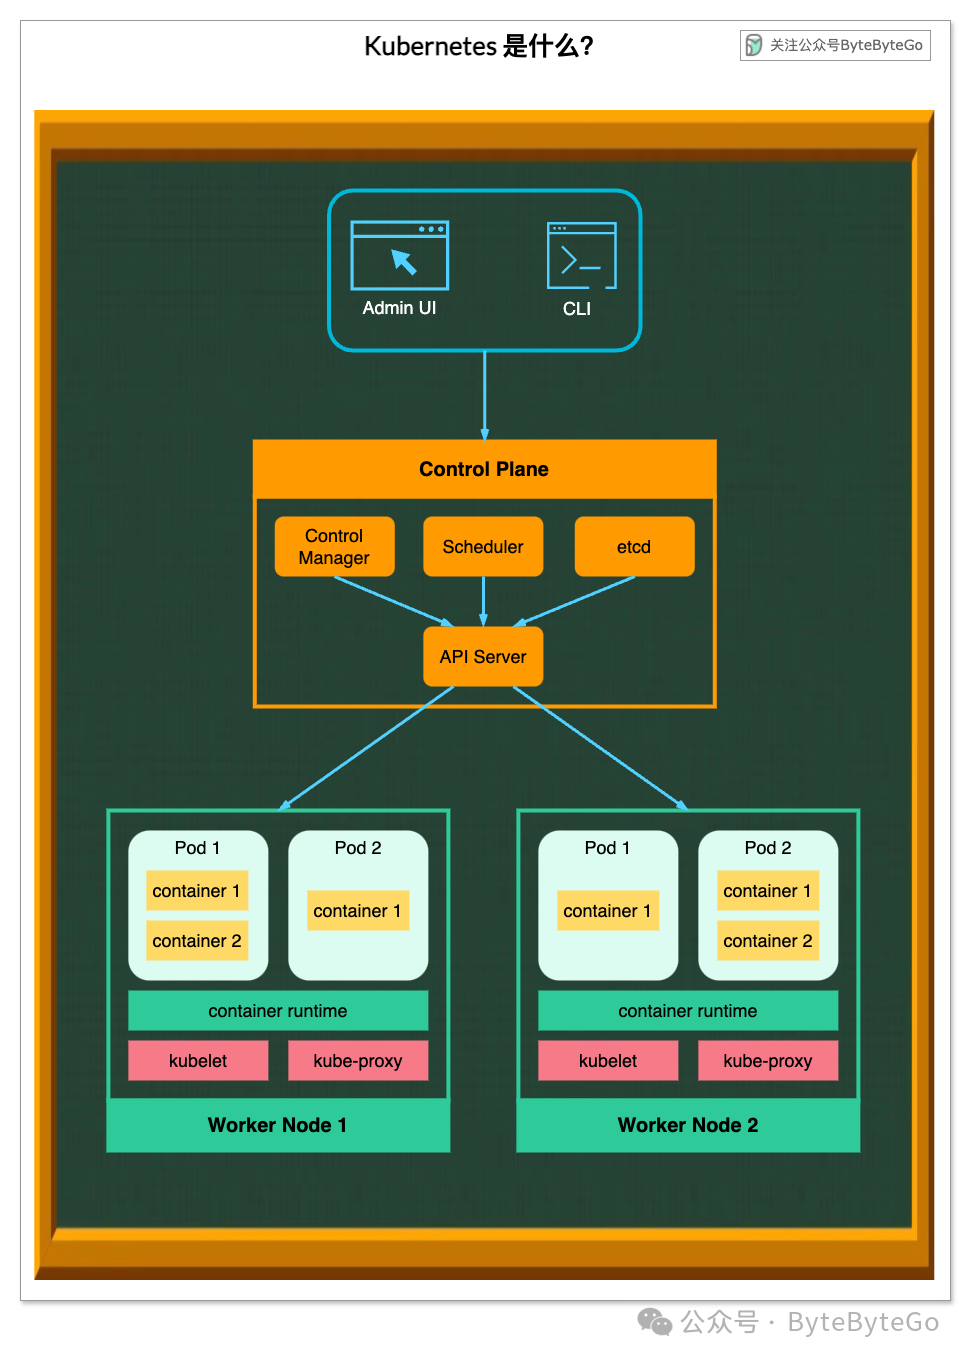
- 控制面板
- kube-apiserver。API 服务器与 k8s 集群中的所有组件对话。Pod 上的所有操作都是通过与 API 服务器对话来执行的。
- kube-scheduler。调度器负责监控 pod 上的工作负载,并为新创建的 pod 分配负载。
- kube-controller-manager。控制器管理器运行控制器,包括 Node Controller、Job Controller、EndpointSlice Controller 和 ServiceAccount Controller。
- etcd。etcd 是一个键值存储,用作 Kubernetes 所有集群数据的后备存储。
- 节点
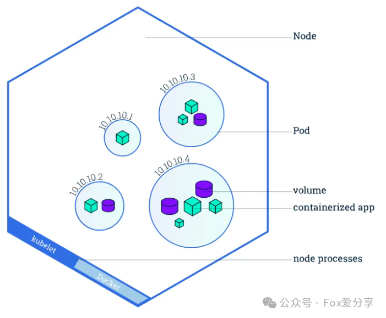
- pod。由一组容器组成,是k8s管理的最小单元。Pod 中的每个容器都有一个 IP 地址。
- kubelet。每个节点上运行 kubelet,负责维护容器的生命周期,同时也负责卷(Volume)和网络(Network)。
- Kube-proxy。是一个网络代理,在集群中的每个节点上运行。它可以路由从服务进入节点的流量。它将工作请求转发给正确的容器。
- 其他
- cloud-controller-manager,主要用于与主要云提供商集成,以及容器运行时。
2. 思维模型
声明式状态机思维模型:
采用声明式,而非命令式。也就是声明我想要的结果而不是如何实现结果。例如:
- 声明"我想要 3 个这个 Pod 的副本"(期望状态)
- Kubernetes 不断检查实际运行的副本数量(当前状态)
- 如果太少或太多,它会创建或删除 Pod
- 这个检查和协调循环不断运行
可以理解为Kubernetes 是自愈的,无需人工过多参与。
巨型计算机思维模型
将 Kubernetes 想象成一台巨大的计算机,其中:
- 整个 K8s 集群是您的"计算机"。控制平面就像操作系统内核
- 每个节点就像主板的一个核心。也就是:您不关心哪个"CPU 核心"(节点)运行您的"进程"(Pod)
- 总 CPU = 所有节点的 CPU 总和。也就是:资源(CPU/RAM)是一个大池
- 总 RAM = 所有节点的 RAM 总和。也就是:资源(CPU/RAM)是一个大池
- Pod 就像在这台计算机上运行的进程。也就是:kube-scheduler 就像操作系统进程调度器
- 服务就像网络端口。也就是:网络路由(服务/入口)就像端口映射
- 存储就像连接外部驱动器。
思维链
- 声明式:"我想要 3 个副本,每个副本 2 个 CPU"(您定义期望状态)
- 巨型计算机:从所有节点看到总可用资源,找到有足够容量部署这 3 个副本的正确节点
- 控制循环:保持 3 个副本,每个副本 2 个 CPU,通过不断检查当前副本,创建或删除 Pod 以匹配您的声明(维持该状态的机制)
- 层次结构:Deployment → ReplicaSet → Pods。
3. 资源概念
Namespace
    ↳ Deployment
        ↳ ReplicaSet:作用是确保 Pod 数量与期望数量一致
            ↳ Pod:最小的部署单元,包含一个或多个容器,所有容器共享网络和存储。
                ↳ Container
    ↳ Service
        ↳ Endpoints → Pods
    ↳ Ingress:从外部访问 K8s 集群中运行的服务。Ingress是入口,路由到 Service,Service 再路由到 Pod
        ↳ Services
    ↳ ConfigMaps & Secrets:外部配置和敏感信息存储。
资源的关系
- 父 控制着 子的生命周期。
- 删除父,子也会被删除。
- 标签 和 选择器 连接着跨分支的资源。
- 每一层都有自己的控制器。
4. 核心API
每种资源都有对应的标准结构,在k8s中通过yaml描述期望来创建资源。
- API组织:
- apiVersion:告诉使用哪个版本的 API(例如,apps/v1 用于部署、networking.k8s.io/v1 用于网络策略)
- Kind:资源类型:Pod、Deployment、Service。
- 资源结构
- metadata:资源信息(名称、标签、注释),
- spec:您想要的内容(期望状态)
- status:您拥有的内容(当前状态)
- 标签和选择器。通过metadata定义标签,通过spec.selector选择器来筛选资源。
- namespace。命名空间是资源的逻辑分组,用于隔离资源。默认有default和kube-system两个命名空间。
1. API组织:
apiVersion: apps/v1     # 使用哪个 API 版本
kind: Deployment        # 资源类型

2. 资源结构
metadata:              # 资源标识
  name: nginx
  labels:
    app: nginx
spec:                  # 期望状态
  replicas: 3
status:                # 当前状态(系统管理)
  availableReplicas: 2

3. 标签和选择器
kind: Pod
metadata:
  labels:
    app: frontend
    env: prod

# 服务通过标签查找 Pod,不关心具体 Pod
# 匹配这些标签
kind: Service
selector:
  app: frontend
  tier: web

# 更复杂的选择
selector:
  matchLabels:
    app: frontend
  matchExpressions:
    - {key: tier, operator: In, values: [web, cache]}
5. CLI
# 列出资源
kubectl get pods
kubectl get deployments
kubectl get services

# 详细信息
kubectl describe pod my-pod

# 从 YAML 创建、更新资源
kubectl apply -f my-app.yaml

# 编辑现有资源
kubectl edit deployment my-app

# 查看 Pod 日志
kubectl logs my-pod
kubectl logs my-pod -f           # 跟随日志

# 在 Pod 中执行命令
kubectl exec my-pod -- ls /      # 单个命令
kubectl exec -it my-pod -- bash  # 交互式 shell

# 本地测试的端口转发
kubectl port-forward pod/my-pod 8080:80      # 本地:容器
kubectl port-forward svc/my-service 8080:80  # 服务级别
6.简单案例
创建一个具有以下内容的 Web 应用:
- 前端 Web 服务器(nginx)
- 后端 API(简单的 Node.js/Python)
- 通过 ConfigMap 配置通过
- Ingress 外部访问
后端 API
apiVersion: apps/v1
kind: Deployment
metadata:
  name: backend
  labels:
    app: demo
    tier: backend
spec:
  replicas: 2
  selector:
    matchLabels:
      app: demo
      tier: backend
  template:
    metadata:
      labels:
        app: demo
        tier: backend
    spec:
      containers:
      - name: api
        image: demo-api:1.0
        ports:
        - containerPort: 3000
---
apiVersion: v1
kind: Service
metadata:
  name: backend-svc
spec:
  selector:
    app: demo
    tier: backend
  ports:
  - port: 80
    targetPort: 3000
前端
apiVersion: apps/v1
kind: Deployment
metadata:
  name: frontend
  labels:
    app: demo
    tier: frontend
spec:
  replicas: 3
  selector:
    matchLabels:
      app: demo
      tier: frontend
  template:
    metadata:
      labels:
        app: demo
        tier: frontend
    spec:
      containers:
      - name: nginx
        image: nginx:1.14
        ports:
        - containerPort: 80
---
apiVersion: v1
kind: Service
metadata:
  name: frontend-svc
spec:
  selector:
    app: demo
    tier: frontend
  ports:
  - port: 80
Ingress
apiVersion: networking.k8s.io/v1
kind: Ingress
metadata:
  name: demo-ingress
spec:
  rules:
  - http:
      paths:
      - path: /api
        pathType: Prefix
        backend:
          service:
            name: backend-svc
            port:
              number: 80
      - path: /
        pathType: Prefix
        backend:
          service:
            name: frontend-svc
            port:
              number: 80
部署与测试
# 部署所有内容
kubectl apply -f .

# 观察 Pod 启动
kubectl get pods -w

# 检查服务
kubectl get svc

# 查看日志
kubectl logs -l app=demo

# 扩展前端
kubectl scale deployment frontend --replicas=5

# 端口转发以测试
kubectl port-forward svc/frontend-svc 8080:80
Namespace
K8s 中,命名空间(Namespace)提供一种机制,将同一集群中的资源划分为相互隔离的组。同一命名空间内的资源名称要唯一,命名空间是用来隔离资源的,不隔离网络。
Kubernetes 启动时会创建四个初始命名空间:
- default:Kubernetes 包含这个命名空间,以便于你无需创建新的命名空间即可开始使用新集群。
- kube-node-lease:该命名空间包含用于与各个节点关联的 Lease(租约)对象。 节点租约允许 kubelet 发送心跳, 由此控制面能够检测到节点故障。
- kube-public:所有的客户端(包括未经身份验证的客户端)都可以读取该命名空间。 该命名空间主要预留为集群使用,以便某些资源需要在整个集群中可见可读。 该命名空间的公共属性只是一种约定而非要求。
- kube-system:该命名空间用于 Kubernetes 系统创建的对象。
# 查看namespace
kubectl get namespace

#查看kube-system下的pod
kubectl get pods -n kube-system

#查看所有namespace下的pod
kubectl get pods -A

# 创建命名空间
kubectl create namespace tuling

# 使用yaml方式创建
apiVersion: v1
kind: Namespace
    metadata:
        name: my_namespace

# 运行
kubectl apply -f my-namespace.yaml

# 删除命名空间
kubectl delete namespace tuling
kubectl delete -f my-namespace.yaml
Pod
1.Pod简介
Pod 是可以在 Kubernetes 中创建和管理的、最小的可部署的计算单元。Pod包括一个或多个容器; 这些容器共享存储、网络、以及怎样运行这些容器的声明。
命令行方式
# 创建pod
kubectl run mynginx --image=nginx:1.14.2

# 获取pod的信息,-owide 表示更详细的显示信息  -n 命名空间 查询对应namespace下的pod
kubectl get pod
kubectl get pod -owide
kubectl get pod -owide -n <namespace-name>

#查看pod的详情
kubectl describe pod <pod-name>

# 查看Pod的运行日志
kubectl logs <pod-name>

# 删除pod
kubectl delete pod <pod-name>
yaml方式
apiVersion: v1
kind: Pod
metadata:
   labels:
      run: mynginx
   name: mynginx
spec:
   containers:
   - name: nginx
      image: nginx:1.14.2
      ports:
      - containerPort: 80
   - name: tomcat
      image: tomcat:9.0.55
2.容器类型
pod是k8s运行的最小单元。支撑pod运行的容器可以有多个,主要分为以下几种
- 初始化容器。在主容器启动前运行,用于执行初始化任务(如配置下载、依赖检查、数据预热等)
- 临时容器。调试用途
- 主容器。核心业务逻辑
- sidecar容器。辅助主容器,负责为主容器提供增强功能,如日志收集、数据同步、服务代理等。
3.Sidecar
Sidecar是最常用的容器类型。关键特点:
- 同一个 Pod:主容器和 Sidecar 容器运行在同一个 Pod 中,属于同一个生命周期。
- 二者共享 Pod 的资源:共享网络、存储卷等资源,能通过 localhost 直接通信。
以下为sidecar案例,其中
- app-container。是主容器,运行nginx。nginx的日志生成到 /var/log/nginx目录
- sidecar-container。是sidecar容器,运行fluentd。fluentd读取nginx的日志并发送到log-server
- 共享存储卷。定义了一个name是shared-logs的卷,用于存放日志文件,主容器和sidecar容器都挂载了这个目录。
apiVersion: v1
kind: Pod
metadata:
  name: sidecar-demo
spec:
  containers:
  - name: app-container
    image: nginx:latest
    volumeMounts:
    - name: shared-logs
      mountPath: /var/log/nginx
  - name: sidecar-container
    image: fluentd:latest
    args:
    - "--log-file=/var/log/nginx/access.log"
    - "--destination=http://log-server"
    volumeMounts:
    - name: shared-logs
      mountPath: /var/log/nginx
  volumes:
  - name: shared-logs
    emptyDir: {}
架构图如下:
+--------------------------- Pod ---------------------------+
|                                                           |
|  +----------------+        +--------------------------+   |
|  | App Container  |        | Sidecar Container        |   |
|  | --------------  |       | -----------------------  |   |
|  | - App Logic     |       | - Logging Agent          |   |
|  | - Generates Logs|       | - Sends Logs to Server   |   |
|  +----------------+        +--------------------------+   |
|             ^                           ^                 |
|             | Shared Volume             | Shared Network  |
|             v                           v                 |
|       Logs (/var/log)           Communication (localhost) |
|                                                           |
+-----------------------------------------------------------+
工作负载workloads
工作负载workloads 是 Kubernetes 集群中负责自动化管理和维护特定资源类型的组件。 包括:无状态应用Deployment、有状态应用StatefulSet、守护进程DaemonSet、任务Job、批处理任务CronJob。
1.类型
- ReplicaSet
- 功能:确保某个 Pod 的指定副本数始终运行。
- 工作原理:如果某些 Pod 停止工作,ReplicaSet 会创建新的 Pod 来替换这些失败的 Pod。它确保集群中有指定数量的 Pod 副本。
- 场景:用于无状态应用的容器集群。
- Deployment
- 功能:管理 无状态应用的创建和更新,支持 Pod 的滚动更新和回滚操作,支持动态扩容,使Pod拥有多副本,自愈,扩缩容等能力。
- 工作原理:确保一定数量的 Pod 副本正在运行,并支持无停机的升级。如果新的 Pod 配置不符合期望,Deployment 会自动回滚到上一版本。
- 场景:用于部署无状态应用,支持版本更新、滚动升级等功能。
- StatefulSet
- 功能:管理有状态应用的部署,保证 Pod 顺序和持久化存储
- 工作原理:不同于 ReplicaSet,StatefulSet 会为每个 Pod 分配持久化存储(如 PersistentVolume),并确保 Pod 在重启或调度时保持顺序性。
- 场景:用于管理有状态服务,如数据库、缓存等需要持久化和顺序管理的应用。
- DaemonSet
- 功能:确保在集群中的每个节点上都运行一个 Pod。
- 工作原理:DaemonSet 会在每个新节点上启动一个 Pod,适用于需要在每个节点上运行的服务,如日志收集、监控代理。
- 场景:运行集群级别的后台进程(如 Fluentd、Prometheus Node Exporter)。
- Job
- 功能:用于管理一次性任务,确保任务完成后退出。
- 工作原理:Job 会创建一个或多个 Pod 执行指定任务,直到任务完成。
- 场景:处理批处理任务、数据迁移等一次性任务。
- CronJob
- 功能:用于定时执行任务,类似于 Unix/Linux 系统中的 Cron。
- 工作原理:CronJob按照指定的时间表创建 Job 资源,定期执行任务。
- 场景:定时备份、定期清理日志等。
2.工作流程
- 创建资源:用户通过定义 YAML 或 JSON 文件来描述资源的期望状态,例如定义一个 Deployment。
- 获取资源状态:控制器通过 Informer 获取集群资源的实际状态,包括 Pods、Deployments 等。
- 比较实际状态和期望状态:控制器比较集群中资源的实际状态与用户定义的期望状态。
- 差异计算:如果实际状态与期望状态不同,控制器会计算出差异并采取行动(如创建、删除或更新资源)来纠正实际状态。
- 状态同步:控制器根据计算的差异采取行动,直到实际状态与期望状态一致。
- 持续监控:控制器不断循环,监控资源的状态,并根据变化做出调整。
3.核心组件
一个标准的控制器包含以下几个核心部分:
- Informer:定期从 Kubernetes API 服务器获取集群资源的当前状态。
- Reconciler:负责比较实际状态与期望状态,并采取措施修正差异。
- Event Handler:处理资源状态变化时触发的事件,如资源创建、更新或删除。
- Controller Loop:控制器的核心循环,它负责不断从集群中拉取资源状态,进行差异计算并调整状态。
本质:控制器模式是一种事件驱动的编程模型,它通过开启定时任务不断的监视资源状态的变化并采取行动来确保集群资源的期望状态。
4.设计模式
控制器模式是面向事件驱动的编程模型,遵循以下基本设计模式:
- 观察者模式:控制器不断监视 Kubernetes API 服务器中的资源状态变化,类似于观察者模式,自动响应状态的变化。
- 补偿模式(Reconciliation Pattern):控制器将实际状态与期望状态进行比较,发现差异后采取补偿措施,确保集群状态与期望一致。
5.Operator
Operator 是对控制器模式的扩展,它允许开发者创建自定义的控制器来管理复杂的应用程序。通过 Operator,用户可以将应用程序的管理逻辑自动化,如自动升级、备份、扩容等。
区别:
- 控制器:通常处理基本的资源管理任务,适用于 Kubernetes 核心资源。
- Operator:通过自定义控制器来处理特定应用的生命周期管理,包括应用的部署、升级和备份等。
6.应用场景
- 自动扩展与容错:例如,ReplicaSet 和 Deployment 控制器负责确保应用的高可用性和自动扩展。
- 无状态和有状态应用的管理:如 Deployment 和 StatefulSet 控制器分别用于管理无状态和有状态应用。
- 集群管理:如 DaemonSet 用于在每个节点上运行代理服务,管理集群级别的功能。
- 批处理与定时任务:Job 和 CronJob 控制器适用于管理一次性或定时任务。
- 自定义资源管理:通过创建 Operator,用户可以为自己的应用程序创建特定的控制器,自动化管理应用生命周期。
7.DaemonSet
作用:
- 节点级服务:DaemonSet 用于在每个节点上部署 Pod,通常用于集群级别的后台服务。例如,日志收集、节点监控、网络代理等服务需要在每个节点上运行。
- 自动管理 Pod:当集群中新增节点时,DaemonSet 会自动为该节点部署一个新的 Pod;当节点被删除时,DaemonSet 会自动删除该节点上运行的 Pod。
查看 DaemonSet 的状态:kubectl get daemonset
NAME          DESIRED   CURRENT   READY   UP-TO-DATE   AVAILABLE   NODE SELECTOR   AGE
fluentd       3         3         3       3            3           <none>          10m
node-exporter 3         3         3       3            3           <none>          15m

DESIRED:        期望的 Pod 数量;
CURRENT:        当前运行的 Pod 数量;
READY:          就绪的 Pod 数量;
UP-TO-DATE:     更新后的 Pod 数量;
AVAILABLE:      可用的 Pod 数量。
1.日志收集和聚合。在每个节点上运行一个日志收集器(如 Fluentd 或 Filebeat),收集日志并转发到集中式日志存储系统(如 Elasticsearch、Kibana、Logstash 等)。
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: fluentd
spec:
  selector:
    matchLabels:
      name: fluentd     # 选择哪些节点应该运行 DaemonSet 管理的 Pod,通常会与 Pod 模板的标签进行匹配。
  template:
    metadata:
      labels:
        name: fluentd   # Pod 模板,定义要运行的容器及其配置。
    spec:
      containers:
      - name: fluentd
        image: fluentd:latest
        volumeMounts:
        - name: varlog
          mountPath: /var/log
  updateStrategy:           # 更新策略,指定如何更新 DaemonSet 的 Pod,通常有两种策略
                            #   RollingUpdate(默认):滚动更新方式,逐步替换 Pod。
                            #   OnDelete:手动删除 Pod 时才进行替换。
    type: RollingUpdate     # 默认为滚动更新,可以逐步替换旧的 Pod
    rollingUpdate:
      maxUnavailable: 1     # 在更新过程中,最多允许不可用的 Pod 数量
  volumes:
  - name: varlog
    hostPath:
      path: /var/log
      type: Directory

2.节点监控:使用 Prometheus Node Exporter 或其他监控代理在每个节点上收集系统级指标(如 CPU、内存、磁盘、网络等),并将数据推送到 Prometheus 监控系统。
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: node-exporter
spec:
  selector:
    matchLabels:
      name: node-exporter
  template:
    metadata:
      labels:
        name: node-exporter
    spec:
      containers:
      - name: node-exporter
        image: prom/node-exporter:latest
        ports:
        - containerPort: 9100

3.网络代理和服务网格。在每个节点上运行网络代理,确保每个节点的流量都能通过网络代理进行管理。例如,使用 Istio 或 Linkerd 等服务网格技术时,可能需要将 Sidecar Proxy 部署为 DaemonSet 以管理每个节点的流量。
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: istio-proxy
spec:
  selector:
    matchLabels:
      app: istio-proxy
  template:
    metadata:
      labels:
        app: istio-proxy
    spec:
      containers:
      - name: proxy
        image: istio/proxyv2:latest
        ports:
        - containerPort: 15001

4.防火墙和安全代理。使用 DaemonSet 部署防火墙代理或安全代理,确保每个节点都进行安全监控或数据过滤。例如,Calico 网络插件会在每个节点上部署网络安全代理。
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: calico-node
spec:
  selector:
    matchLabels:
      name: calico-node
  template:
    metadata:
      labels:
        name: calico-node
    spec:
      containers:
      - name: calico
        image: calico/node:latest
Service
Service 流量路径:当一个 Pod 访问某个 Service 的 ClusterIP 时,流量路径大致为: 访问 Pod → 节点的网络规则(iptables/IPVS,由 kube-proxy 维护)→ 转发到 Endpoints 中的某个后端 Pod → 目标 Pod
1.基础
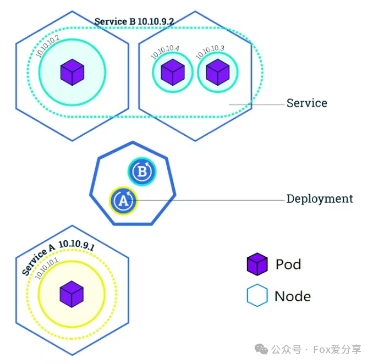
Service是一个抽象层,定义了一组 Pod 的访问策略,并为这些Pod提供唯一的统一的网络入口,通过 Service,你可以将请求路由到后端的一组 Pod 上,从而实现负载均衡和服务的发现。
原因:尽管每个Pod 都有一个唯一的IP地址,但是Pod 是有生命周期的(可能因故障重启、被调度到其他节点、扩缩容等原因被销毁重建),其 IP 会动态变化(每次重建都会生成新 IP)。 因此pod之间通信和外部访问Pod都需要一个稳定的抽象层,这就是Service。
2.类型
在 Kubernetes 中,ServiceSpec 的 type 字段用于定义 Service 的访问方式和范围,主要有以下几种类型:
- ClusterIP(默认类型)
- 特点:为 Service 分配一个仅在集群内部可见的虚拟 IP(ClusterIP),只能被k8s集群内的Pod或组件访问。Service提供了简单的负载均衡算法,默认随机访问代理的pod。
- 用途:适用于仅需要集群内部通信的服务(如数据库、MQ、内部API等)。
- 特殊变体:Headless Service(无 ClusterIP):当 clusterIP=None 时,Service 不会分配虚拟 IP,而是通过 DNS 直接返回后端 Pod 的 IP 列表, 适用于需要自行处理负载均衡或 StatefulSet 等场景。
- NodePort
- 特点:在 ClusterIP 基础上,利用NAT技术在宿主上开放一个静态端口。外部通过宿主IP(任意节点ip) + NodePort访问 Service。
- 用途:需要从集群外部临时访问服务(如开发测试场景),但不适合生产环境(端口管理复杂,暴露节点风险)。
- LoadBalancer
- 特点:在 NodePort 基础上,利用云服务商的负载均衡器(如 CLB、SLB 等)自动绑定宿主IP + NodePort。外部流量通过云负载均衡器转发到 NodePort,再到 Service 后端 Pod。
- 用途:生产环境中需要稳定外部访问入口的服务,依赖云服务商的负载均衡器支持。
- ExternalName
- 特点:通过 DNS CNAME 记录将 Service 映射到一个外部域名(如 example.com),无需选择器(selector),也不关联任何 Pod。
- 用途:将集群内部服务与外部服务(如第三方 API、外部数据库)关联,统一访问方式(通过 Service 名称访问外部域名)。
- 目的:集群内部网络是无法访问公网,所以使用ExternalName让集群内部pod访问外部网络。
2.1.LoadBalancer
配置的核心逻辑一致(通过 type: LoadBalancer 声明),但由于各厂商的负载均衡服务实现不同,需通过 厂商特定的注解(Annotations) 进行定制(如网络类型、带宽、安全组等)。
基础操作流程:以阿里云(ACK 集群)创建公网类型的NLB 为例:
# aliyun-lb-service.yaml 使用kubectl执行命令自动创建NLB服务,并分配ip
apiVersion: v1
kind: Service
metadata:
  annotations:
    service.beta.kubernetes.io/alibaba-cloud-loadbalancer-zone-maps: "cn-hangzhou-k:vsw-i123456,cn-hangzhou-j:vsw-j654321"
    # 网络类型:internet 表示公网,intranet 表示内网
    service.beta.kubernetes.io/alibaba-cloud-loadbalancer-address-type: "internet"
    # NLB名称。
    service.beta.kubernetes.io/alibaba-cloud-loadbalancer-name: "your-nlb-name"
    # 资源组ID
    service.beta.kubernetes.io/alibaba-cloud-loadbalancer-resource-group-id:  "your-resource-group-id"
    # nlb协议版本:ipv4 或 DualStack(ipv4和IPv6 双栈)
    service.beta.kubernetes.io/alibaba-cloud-loadbalancer-ip-version: "ipv4"
    # 设置标签
    service.beta.kubernetes.io/alibaba-cloud-loadbalancer-additional-resource-tags: "Key1=Value1,Key2=Value2"
    # 【不可与上述的注解一起使用】绑定已有的NLB。
    service.beta.kubernetes.io/alibaba-cloud-loadbalancer-id: "${your-nlb-id}"
    # 带宽包ID,用于绑定已有的带宽包。
    service.beta.kubernetes.io/alibaba-cloud-loadbalancer-bandwidth-package-id: "cbwp-xxxxxxxxxx"
    # 绑定安全组:多个安全组使用逗号分隔。
    service.beta.kubernetes.io/alibaba-cloud-loadbalancer-security-group-ids: "sg-aaaaa,sg-bbbbb"
  name: nginx
  namespace: default
spec:
  externalTrafficPolicy: Local
  ports:
  - name: tcp
    port: 80
    protocol: TCP
    targetPort: 80
  - name: https
    port: 443
    protocol: TCP
    targetPort: 443
  selector:
    app: nginx
  # 指定负载均衡使用NLB
  loadBalancerClass: "alibabacloud.com/nlb"
  type: LoadBalancer
2.2.ExternalName
# externalname-service.yaml
apiVersion: v1
kind: Service
metadata:
  name: external-weather-api    # 集群内访问用的Service名称
  namespace: app                # Service所在的命名空间
spec:
  type: ExternalName
  externalName: weather.example.com  # 外部服务的域名(必须是有效的域名,不能是IP)
上述 Service 名称为 external-weather-api,位于 app 命名空间,Pod 中可通过以下域名访问外部服务:
http://external-weather-api.default.svc.cluster.local/

如果在同一个namespace中,可以只使用前缀就能访问:http://external-weather-api/
3.Ingress
官网地址:https://kubernetes.github.io/ingress-nginx/
k8s 还通过 Ingress 资源提供更灵活的外部访问管理(如 HTTP/HTTPS 路由、域名绑定等),但 Ingress 不是 Service 的类型,而是独立的资源,需配合 Ingress Controller 使用。
Ingress 和 Service 区别:都是流量路由到应用程序的机制,但它们在路由层面上有所不同:
- Service 是抽象的应用程序服务,它公开了一个单一的IP地址和端口,可以用于在k8s集群内部的 Pod 之间进行流量路由。
- Ingress 是一个 Kubernetes 资源对象,它提供了对集群外部流量路由的规则。Ingress 通过一个公共IP地址和端口将流量路由到一个或多个Service。
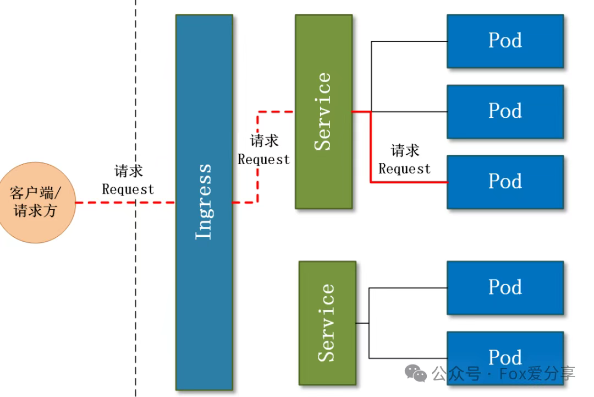
查看分配的IP:
Nginx Ingress:kubectl get svc -n ingress-nginx
Istio:kubectl get svc istio-ingressgateway -n istio-system
输出中 EXTERNAL-IP 即为外部访问地址
- 有值:通常会分配1~4个IP(宿主的IP)
- 无值(云 LB 或 NodePort):用任意节点公网 IP + NodePort
4.服务发现与监控检查
K8s 本身提供了最基础的 "服务发现能力",无需额外部署第三方组件,是云原生环境的 "默认选项"。
service属于k8s集群内部的DNS服务,通过Service名称访问后端Pod。例如 namespace=mail的服务,其中service=pay。 同一个namespace通过关键字pay就可以访问到,其他namespace通过 pay.mail.svc.cluster.local 访问,类似于域名的方式。
实现原理
- 基于 "标签选择器(Label Selector)" 关联 Pod,自动维护服务 IP(ClusterIP/NodePort/LoadBalancer);
- 内置健康检查(通过 Pod 的livenessProbe/readinessProbe剔除故障实例);
- 依赖 K8s DNS(如 CoreDNS)实现 "服务名→IP" 的解析(如my-service.default.svc.cluster.local)。
4.最佳实践
- 案例1:基于springcloud+naos/eureka的微服务。首选ClusterIP,因为应用注册时使用的是pod ip,重点是应用端口不唯一,而eureka用的是service ip。
- 案例2:基于springcloud gateway/zuul的微服务。首选NodePort,网关服务使用统一的端口暴露接口。
- 案例3:基于nginx的前端服务,首选NodePort,提供统一访问。
- 案例4:复杂路由,使用Ingress,提供更灵活的路由规则,用于转发流量到不同的service中。
- 案例5:例如MySQL、kafka、redis等基础服务。可以使用Service 的 ClusterIP + Kubernetes 集群内置的 DNS 服务(如 CoreDNS)进行访问。 实现k8s集群内部的玉米解析。例如定义 mysql.default.svc.cluster.local 指向 mysql pod 的 ClusterIP。
5.工作原理
Service 的核心作用是为动态变化的 Pod 提供稳定的访问入口,并实现 Pod 之间的通信与负载均衡。其实现原理和服务发现机制依赖于 Kubernetes 的多个核心组件协同工作。
- ClusterIP:通过 kube-proxy 组件,将 Service 的 ClusterIP 与 Pod IP 进行映射。当访问 ClusterIP 时,流量被转发到后端 Pods。
- 标签选择器(Selector)与 Endpoints。Service 通过 spec.selector 与后端 Pod 关联(如 app: nginx),并通过 Endpoints 资源实时更新后端 Pod 的 IP 和端口信息。
- kube-proxy:流量转发与负载均衡。在每个节点上运行 kube-proxy,它的核心作用是监听 Service 和 Endpoints 的变化,并在每个节点上配置 iptables 规则或 IPVS 规则(取决于 kube-proxy 的模式),实现流量转发和负载均衡。
6.服务发现机制
主要通过DNS实现,辅以环境变量:
- 环境变量。每个 Pod 启动时,会注入环境变量 KUBERNETES_SERVICE_HOST 和 KUBERNETES_SERVICE_PORT,指向 Kubernetes API Server 的地址和端口。
- DNS 服务(如 CoreDNS)。通过 Service 名称访问后端 Pods,例如访问 my-service 会自动解析到 my-service.default.svc.cluster.local。
- Headless Service。当 ClusterIP 为 None 时,Service 不分配虚拟 IP,而是直接返回后端 Pod 的 IP 列表,适用于需要自行处理负载均衡的场景。
存储卷Volume
在 k8s 中,存储是应用的重要组成部分,尤其是对于需要持久化数据的应用,如数据库、文件存储等。
1.存储资源类型
- Ephemeral Storage(临时存储)指 k8s 容器生命周期内存储的数据。当容器终止或者被销毁时,临时存储的数据将会丢失。临时存储的例子包括:
- emptyDir:一个临时的空目录,在容器启动时创建,可以在 Pod 中用来存储临时数据,容器终止时删除。
- hostPath:挂载主机上的文件或目录,通常用于调试或测试,但不适合持久化数据,因为数据会依赖宿主机。
- Persistent Storage(持久化存储) 用于存储需要在 Pod 重启或迁移时保持的数据。k8s 提供了以下持久化存储解决方案:
- Persistent Volume (PV):集群中的一块存储资源。由管理员预先配置,代表外部存储(如 NFS、GlusterFS、Ceph、云存储等)。
- Persistent Volume Claim (PVC):用户向 k8s 请求存储资源的方式。PVC 表示应用所需的存储量,k8s 会将其与 PV 绑定,提供相应的存储。
- 其他存储类型
- ConfigMap 和 Secret:这两种 k8s 资源用于存储配置信息或敏感数据,可以被容器挂载为文件或作为环境变量传递。
- StatefulSet:用于需要持久化存储的有状态应用。StatefulSet 自动管理与存储相关的细节,每个 Pod 都可以有自己的持久化存储。
在 k8s 中,存储和持久化数据是关键的基础设施之一。PV 和 PVC 提供了灵活的存储管理方式,使应用可以依赖于 k8s 提供的持久化存储来保存数据。
- PV:管理员创建的存储资源,可能是云存储、NFS 等。
- PVC:用户的存储需求声明,k8s 会根据 PVC 绑定适当的 PV。
- StorageClass:提供动态存储卷供应的功能,可以根据存储类型(如云存储)配置动态创建 PV。
通过正确使用 PV、PVC 和 StorageClass,k8s 可以为容器化应用提供高效、可靠、持久的存储解决方案。
2.PV
Persistent Volume (PV) 是集群中管理员预配置的存储资源。PV 可以使用多种存储技术(如 NFS、iSCSI、Ceph、云存储等)来提供持久化存储。 PV 是由管理员创建的,存储资源具有生命周期,可以在多个 Pod 之间共享。
PV 是集群中的资源对象,类似于节点或 pod 的其他资源。管理员通过 YAML 文件定义 PV,并将其与物理存储资源相关联。
apiVersion: v1
kind: PersistentVolume
metadata:
  name: my-pv
spec:
  capacity:
    storage: 5Gi          # 指定存储的大小
  volumeMode: Filesystem
  accessModes:
    - ReadWriteOnce       # 定义 PV 可以被访问的模式(如 ReadWriteOnce、ReadOnlyMany、ReadWriteMany)
  persistentVolumeReclaimPolicy: Retain   #定义回收策略,如 Retain(保留)、Recycle(回收)、Delete(删除)。
  storageClassName: standard  # 存储的类型(例如使用某个存储类)
  hostPath:
    path: /mnt/data           # 使用本地存储作为持久化存储,通常用于开发和测试环境
3.PVC
Persistent Volume Claim (PVC) 是用户对存储资源的请求,它定义了需要的存储大小、访问模式等要求。PVC 会与合适的 PV 绑定,确保应用可以使用到所需的存储。 PVC 是用户创建的,它描述了应用所需的存储资源(如大小和访问模式)。k8s 会根据 PVC 的要求找到适合的 PV,并将它们绑定在一起。
当 PVC 被创建时,k8s 会寻找符合该请求的 PV 并将其绑定。如果有多个 PV 满足条件,k8s 会根据存储类、容量等选择最佳匹配。
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: my-pvc
spec:
  accessModes:
    - ReadWriteOnce # 请求存储的访问模式
  resources:
    requests:
      storage: 5Gi  #请求的存储大小
4.PVC和PV的绑定
- 动态供应:如果没有预先创建的 PV 可以满足 PVC 的请求,k8s 可以使用 StorageClass 来动态创建 PV。
动态访问方式的优点:
- 灵活性高,无需管理员手动干预,适合大规模、自动化环境。
- 动态供应存储卷,减少人工配置和管理的工作量。
动态访问方式的缺点:
- 需要管理员配置适当的 StorageClass 和存储提供者。
- 可能存在存储资源使用不均衡的风险,需进行资源管理和监控。
动态供应案例:用户创建的 PVC 会自动使用 StorageClass(standard)来动态供应存储。
1. 创建 StorageClass(storageclass.yaml)
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: standard
provisioner: kubernetes.io/aws-ebs
parameters:
  type: gp2

2. 创建 PVC 并使用 StorageClass(pvc-dynamic.yaml)
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: my-pvc
spec:
  accessModes:
    - ReadWriteOnce
  resources:
    requests:
      storage: 5Gi
  storageClassName: standard
- 静态供应:如果管理员手动创建了 PV,则 k8s 会根据 PVC 的要求将 PVC 与 PV 进行匹配,并绑定在一起。
静态访问方式的优点:
- 提供明确的存储资源控制,可以手动配置 PV 来匹配特定的存储需求。
- 适用于已有存储设备或对存储资源有特殊要求的场景。
静态访问方式的缺点:
- 不够灵活,管理员需要预先创建 PV,管理工作量较大。
- 难以应对动态需求,特别是在存储需求变化频繁的环境中。
静态访问示例:管理员创建了一个 10Gi 的 PV,Pod 通过 PVC 请求 5Gi 的存储。PVC 会和符合要求的 PV(即 10Gi)绑定
1. 创建 PV(pv.yaml)
apiVersion: v1
kind: PersistentVolume
metadata:
  name: my-pv
spec:
  capacity:
    storage: 10Gi
  volumeMode: Filesystem
  accessModes:
    - ReadWriteOnce
  persistentVolumeReclaimPolicy: Recycle
  storageClassName: manual
  hostPath:
    path: /mnt/data

2. 创建 PVC(pvc.yaml)
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: my-pvc
spec:
  accessModes:
    - ReadWriteOnce
  resources:
    requests:
      storage: 5Gi
  storageClassName: manual
5.StorageClass 和动态卷供应
StorageClass 是一种用于动态供应存储卷的方式。管理员可以创建一个或多个 StorageClass,定义不同的存储类型和配置(例如基于不同云平台的存储)。
当 PVC 指定了某个 StorageClass 时,k8s 会使用该 StorageClass 中定义的策略动态创建 PV。
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: fast-storage
provisioner: kubernetes.io/aws-ebs    # 存储供应器,指定存储类型(如 AWS EBS、GCE PD、Ceph、NFS 等)。
parameters:
  type: gp2                           # 存储类型,例如 gp2(通用SSD卷)、io1(IOPS优化SSD卷)等。
6.访问模式
PV 和 PVC 都使用 访问模式 (Access Modes) 来控制如何访问存储资源,常见的访问模式有:
- ReadWriteOnce:只能由一个节点以读写方式访问。
- ReadOnlyMany:可以由多个节点以只读方式访问。
- ReadWriteMany:可以由多个节点以读写方式访问。
选择合适的访问模式对应用非常重要,尤其是在有多个副本或多个节点时。
7.使用场景
- 数据库存储:对于需要持久化数据的应用(如 MySQL、PostgreSQL、Redis 等数据库),可以使用 PV 和 PVC 来提供可靠的存储。
- 文件存储:如果应用需要存储文件,k8s 也可以使用 PV 和 PVC 来提供持久化存储,并使文件在 Pod 重启或迁移时依然可用。
- 共享存储:某些应用可能需要多个 Pod 共享同一个存储卷。在这种情况下,可以使用 PVC 配合 ReadWriteMany 或 ReadOnlyMany 访问模式来实现共享存储。
- 备份和恢复:PV 可以用于存储应用的备份数据,以便在应用或容器发生故障时进行恢复。
8.管理和生命周期
k8s 中的存储生命周期管理通常分为以下几种情况:
回收策略:
- Retain:当 PVC 被删除时,PV 保留不变,管理员需要手动回收资源。
- Recycle:删除 PVC 后,PV 的数据会被清空并重新可用(此选项已不推荐使用)。
- Delete:当 PVC 被删除时,PV 也会被删除(适用于动态供应的存储)。
持久化数据的迁移:可以通过 PV 和 PVC 配置,确保数据在 Pod 或容器迁移、重启时不会丢失。
9.ConfigMap
ConfigMap 是 Kubernetes 中管理应用配置的标准方式,适用于以下场景:
- 外部配置管理:通过 ConfigMap 将应用的配置文件外部化,使得容器在运行时能够灵活地读取和应用配置,而不需要重新构建 Docker 镜像。
- 环境配置:不同环境(如开发、测试、生产)可能需要不同的配置,ConfigMap 可以根据环境将配置动态地注入到容器中。
命令
查看集群中的所有 ConfigMap:kubectl get configmap
更新 ConfigMap:kubectl apply -f configmap.yaml
删除 ConfigMap:kubectl delete configmap <configmap-name>
设置ConfigMap
1. 使用yaml定义公共的配置。name=app-config
apiVersion: v1
kind: ConfigMap
metadata:
  name: app-config
data:
  DATABASE_HOST: "db.example.com"
  DATABASE_PORT: "3306"
  DATABASE_NAME: "mydb"
  DATABASE_USER: "user"
  DATABASE_PASSWORD: "password"

2. 通过 kubectl 命令行创建 ConfigMap
kubectl create configmap app-config \
  --from-literal=DATABASE_HOST=db.example.com \
  --from-literal=DATABASE_PORT=3306 \
  --from-literal=DATABASE_NAME=mydb \
  --from-literal=DATABASE_USER=user \
  --from-literal=DATABASE_PASSWORD=password

3. 从一个文件或目录创建 ConfigMap:
kubectl create configmap app-config --from-file=./config.json
Pod使用ConfigMap
1. 作为容器的环境变量
apiVersion: v1
kind: Pod
metadata:
  name: app-pod
spec:
  containers:
  - name: app-container
    image: my-app-image
    envFrom:        # envFrom 会将 ConfigMap app-config 中的所有键值对传递给容器作为环境变量
    - configMapRef:
        name: app-config

2. 作为容器的命令行参数。
apiVersion: v1
kind: Pod
metadata:
  name: app-pod
spec:
  containers:
  - name: app-container
    image: my-app-image
    command: ["./app", "--host", "$(DATABASE_HOST)", "--port", "$(DATABASE_PORT)"]
    env:                    # 自定义环境变量
    - name: DATABASE_HOST
      valueFrom:
        configMapKeyRef:
          name: app-config  # 读取    ConfigMap app-config 中的 DATABASE_HOST
          key: DATABASE_HOST
    - name: DATABASE_PORT
      valueFrom:
        configMapKeyRef:
          name: app-config
          key: DATABASE_PORT # 读取    ConfigMap app-config 中的 DATABASE_PORT

3. 作为卷挂载到容器中。如果ConfigMap是文件则可以作为卷直接挂载到容器中。
apiVersion: v1
kind: Pod
metadata:
  name: app-pod
spec:
  containers:
  - name: app-container
    image: my-app-image
    volumeMounts:
    - name: config-volume
      mountPath: /etc/config
  volumes:
  - name: config-volume
    configMap:
      name: app-config
10.Secret
Secret 是一种用于存储和管理敏感信息(如密码、OAuth 令牌、SSH 密钥等)的资源对象。 与 ConfigMap 类似,Secret 允许将配置信息外部化,但 Secret 专门用于存储敏感数据,并且通常会经过加密处理以提高安全性。
Secret 通常用于存储:
- 密码
- API 密钥
- 数据库凭证
- SSH 私钥
- TLS/SSL 证书和密钥
注意事项:
- Secret将数据进行base64 编码并保存到 etcd 中,并不会加密。因此,Kubernetes 提供了 Encryption at Rest 功能,建议启用它以确保 Secret 数据在存储时加密。
- 控制访问权限。k8s强制使用RBAC管理。
设置Secret
1. 使用yaml定义
apiVersion: v1
kind: Secret
metadata:
  name: db-credentials
type: Opaque
data:
  db-username: dXNlcm5hbWU=  # base64 编码后的用户名
  db-password: cGFzc3dvcmQ=  # base64 编码后的密码

2. 命令创建
kubectl create secret generic db-credentials \
  --from-literal=db-username=admin \
  --from-literal=db-password=secretpassword
使用Secret
1. Secret 可以通过环境变量传递给容器
apiVersion: v1
kind: Pod
metadata:
  name: app-pod
spec:
  containers:
  - name: app-container
    image: my-app-image
    env:
    - name: DB_USERNAME
      valueFrom:
        secretKeyRef:
          name: db-credentials
          key: db-username
    - name: DB_PASSWORD
      valueFrom:
        secretKeyRef:
          name: db-credentials
          key: db-password
2.将 Secret 作为文件挂载到容器中
apiVersion: v1
kind: Pod
metadata:
  name: app-pod
spec:
  containers:
  - name: app-container
    image: my-app-image
    volumeMounts:
    - name: secret-volume
      mountPath: /etc/secret
  volumes:
  - name: secret-volume
    secret:
      secretName: db-credentials
核心原理
1.网络模型
K8S的网络中主要存在4种类型的通信:
- 同一Pod内的容器间通信
- 各个Pod彼此间的通信
- Pod和Service间的通信
- 集群外部流量和Service之间的通信
K8S为Pod和Service资源对象分别使用了各自的专有网络,Pod网络由K8S的网络插件配置实现,而Service网络则由K8S集群进行指定。
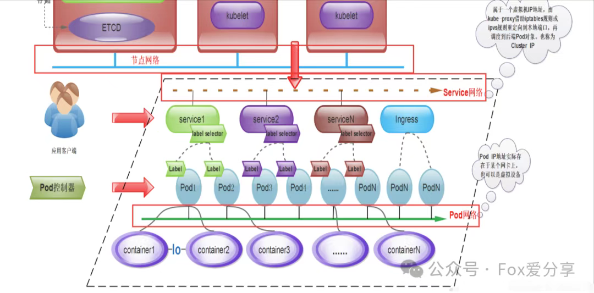
从上图进行总结起来,一个K8S集群包含是三个网络。
- 节点网络:各主机(Master、Node、ETCD等)自身所属的网络,地址配置在主机的网络接口,用于各主机之间的通信,又称为节点网络。
- Pod网络:专用于Pod资源对象的网络,它是一个虚拟网络,用于为各Pod对象设定IP地址等网络参数,其地址配置在Pod中容器的网络接口上。Pod网络需要借助kubenet插件或CNI插件实现。
- Service网络:专用于Service资源对象的网络,它也是一个虚拟网络,用于为K8S集群之中的Service配置IP地址,但是该地址不会配置在任何主机或容器的网络接口上, 而是通过Node上的kube-proxy配置为iptables或ipvs规则,从而将发往该地址的所有流量调度到后端的各Pod对象之上。
2.工作流程
用K8S部署Nginx的过程中,K8S内部各组件是如何协同工作的:
- 创建请求首先发到master节点的网关api server,这是k8s的唯一入口。
- api server将命令请求交给controller mannager进行控制
- controller mannager 进行应用部署解析
- controller mannager 会生成一次部署信息,并通过api server将信息存入etcd。
- scheduler调度器通过api server从etcd存储中,拿到要部署的应用,开始调度看哪个节点有资源适合部署
- scheduler把计算出来的调度信息通过api server再放到etcd中
- 每一个node节点的监控组件kubelet,随时和master保持联系(给api-server发送请求不断获取最新数据),拿到master节点存储在etcd中的部署信息
- 假设node2的kubelet拿到部署信息,显示他自己节点要部署某某应用
- kubelet就自己run一个应用在当前机器上,并随时给master汇报当前应用的状态信息
- node和master也是通过master的api-server组件联系
- 每一个机器上的kube-proxy能知道集群的所有网络,只要node访问别人或者别人访问node,node上的kube-proxy网络代理自动计算进行流量转发
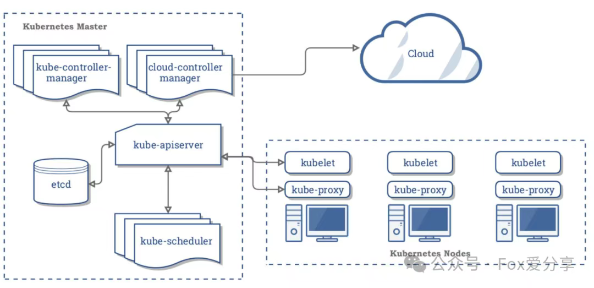
调度与资源管理
Kubernetes 调度和资源管理是其核心功能,负责在集群中高效分配和管理计算资源。通过调度策略、资源限制和优先级控制,Kubernetes 能够确保应用的性能、可靠性和高可用性。
- Pod调度机制:Kubernetes使用调度器(Scheduler)来决定将Pod部署到哪个节点上运行。调度器会根据一系列的调度策略,包括资源需求、节点负载、亲和性和互斥性等因素,选择最合适的节点进行调度。
- 资源限制和请求:在定义Pod时,可以通过资源限制(Resource Limits)和资源请求(Resource Requests)来指定容器对CPU和内存等资源的需求。 资源限制用于限制容器使用的最大资源量,而资源请求则是向调度器申请所需的最小资源量。调度器根据这些需求来选择合适的节点进行调度。
- 自动伸缩:Kubernetes提供了水平自动伸缩(Horizontal Pod Autoscaling,HPA)的功能,可以根据指标(如CPU使用率)自动调整Pod的副本数量。 当负载增加时,HPA会自动增加Pod的副本数量,以满足负载需求;当负载减少时,HPA会自动减少Pod的副本数量,以节省资源。
- 节点管理:Kubernetes通过节点管理器(Node Manager)监控节点上的资源使用情况,包括CPU、内存和存储等。 当节点资源不足时,节点管理器会发出警告并触发自动扩容或迁移Pod的操作,将Pod调度到其他资源充足的节点上。
总的来说,Kubernetes通过调度机制、资源限制和请求、自动伸缩和节点管理等多种方式,实现了对容器资源的动态调配和管理,以确保应用程序能够高效地利用集群资源,并根据负载情况进行自动调整。
1.Pod调度机制
Kubernetes 调度是指将工作负载(如 Pod)分配到合适的节点上运行的过程。调度器(kube-scheduler)是 Kubernetes 的核心组件之一,专门负责此任务。
调度过程
- 调度请求:当用户提交一个 Pod 时,API Server 将其加入调度队列。
- 节点筛选(Filtering):调度器根据一系列预定义规则过滤出满足要求的节点(候选节点)。
- 节点打分(Scoring):为每个候选节点打分,选择分数最高的节点作为目标节点。
- 绑定 Pod:将 Pod 绑定到目标节点,并通过 API Server 通知对应节点的 kubelet 启动 Pod。
调度算法
- 默认调度器采用了插件化设计,支持多种调度算法,包括:
- 预选算法:用于过滤不满足条件的节点。
- 优选算法:为符合条件的节点打分,选择最优节点。
- 用户可以自定义调度逻辑,甚至替换默认调度器。
2.资源管理
Kubernetes 通过资源配额和优先级控制实现资源的合理分配和管理,确保应用的稳定运行并防止资源滥用。
资源类型
- 计算资源:
- CPU:以核为单位,可以指定小数(如 0.5 表示半个 CPU 核)。
- 内存:以字节为单位,支持 Ki、Mi、Gi 等单位。
- 存储资源:
- 使用 PersistentVolume(PV)和 PersistentVolumeClaim(PVC)管理存储。
- 网络资源:
- 管理 Pod 的网络流量和带宽。
资源限制:通过 resources 字段定义 Pod 或容器的资源限制:
resources:
  requests:         # 资源的最低请求值,调度器根据此值选择合适的节点。
    memory: "64Mi"
    cpu: "250m"
  limits:           # 资源的最大使用值,容器运行时不能超过。
    memory: "128Mi"
    cpu: "500m"
资源配额(Resource Quotas)
apiVersion: v1
kind: ResourceQuota
metadata:
  name: compute-quota
spec:
  hard:     # 资源配额。用于限制命名空间内资源的总使用量,防止单个用户或应用占用过多资源。
    pods: "10"
    requests.cpu: "4"
    requests.memory: "8Gi"
    limits.cpu: "10"
    limits.memory: "16Gi"
3.调度策略
默认调度策略
- 资源需求匹配:根据 Pod 的 resources.requests 找到能够满足需求的节点。
- 节点亲和性和反亲和性: 控制 Pod 部署到特定节点或避免特定节点。
- Pod亲和性和反亲和性: 控制 Pod 部署到与其他特定 Pod 相同或不同的节点。
affinity:
  nodeAffinity:             # 1.节点亲
    requiredDuringSchedulingIgnoredDuringExecution:
      nodeSelectorTerms:
      - matchExpressions:
        - key: kubernetes.io/hostname
          operator: In
          values:
          - node1
  podAffinity:              # 2.Pod亲和性
    requiredDuringSchedulingIgnoredDuringExecution:
      labelSelector:
        matchLabels:
          app: web
      topologyKey: "kubernetes.io/hostname"
自定义调度策略:
1.Taints 和 Tolerations:用于限制 Pod 被调度到带有特定污点的节点上。
taints:
- key: "dedicated"
  value: "batch-processing"
  effect: "NoSchedule"
tolerations:
- key: "dedicated"
  operator: "Equal"
  value: "batch-processing"
  effect: "NoSchedule"
2.Priority and Preemption: 优先级定义 Pod 的重要性,优先级高的 Pod 会抢占低优先级 Pod 的资源
apiVersion: scheduling.k8s.io/v1
kind: PriorityClass
metadata:
  name: high-priority
value: 1000000
preemptionPolicy: PreemptLowerPriority
globalDefault: false
description: "This priority class is for high priority pods."
4.自动伸缩
- HPA(Horizontal Pod Autoscaler)。调整pod数量。
- VPA。调整pod资源大小
- Cluster Autoscaler。k8s节点资源不足导致pod分配不到资源,自动伸缩节点数量。(多用于云服务器上)
以下为HPA的案例
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: example-hpa
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: example-deployment
  minReplicas: 1        # 最小副本数
  maxReplicas: 10       # 最大副本数
  metrics:
  - type: Resource
    resource:
      name: cpu                 # CPU使用率高于50%触发
      target:
        type: Utilization
        averageUtilization: 50
基本网络模型
Kubernetes 网络模型定义了 Pod、节点和服务之间的网络通信规则和要求。其目标是为容器化应用提供一致、灵活的网络环境。
- Kubernetes 网络模型 强调 Pod IP 的统一性和直接通信,支持通过 CNI 插件实现灵活的网络架构。
- Netns 提供容器化环境下的网络隔离能力,通过 veth pair 和 CNI 插件实现连接。
- 主流网络方案(如 Flannel、Calico、Cilium)提供多样化选择,以适应不同的集群规模和性能需求。
- Network Policy 是实现网络安全的核心工具,用于精细控制 Pod 的网络流量,提高集群的安全性和隔离性。
1.基本要求
- 每个 Pod 有唯一的 IP 地址:
- Kubernetes 分配给每个 Pod 一个独立的 IP 地址(Pod IP),Pod 内的所有容器共享这个网络命名空间(netns)。
- Pod 可以直接通过 IP 地址与其他 Pod 通信,无需 NAT。
- 所有 Pod 都可以直接相互通信:
- 不论 Pod 是否在同一节点上,都可以通过 Pod IP 实现无障碍通信。
- 节点上的所有 Pod 可以访问外部网络:
- Kubernetes 提供出口 NAT(SNAT),使 Pod 可以访问集群外部资源。
- 服务抽象(Service)提供了 Pod 的稳定访问:
- Kubernetes 使用 ClusterIP、NodePort 或 LoadBalancer 等机制,确保服务可以被其他服务或外部流量访问。
2.网络的三个层次
- Node-to-Node 通信:不同节点上的 Pod 能够通过 Overlay 网络或路由实现直接通信。
- Pod-to-Pod 通信:在同一节点或跨节点,Pod 可以通过虚拟网络接口(veth pair)或其他网络插件实现通信。
- Service-to-Pod 通信:服务通过 kube-proxy 或其他负载均衡机制将流量路由到目标 Pod。
3.Netns
Linux 的网络命名空间(Netns)是实现 Kubernetes 网络隔离的核心机制。
Netns 的定义
- Netns 是 Linux 内核的一种隔离机制,它允许创建多个独立的网络堆栈实例,包括网络接口、路由表、iptables 等。
- 每个容器或 Pod 都运行在一个独立的 Netns 中,实现网络环境的隔离。
Netns 的工作原理
- 主机网络命名空间(Root Netns):主机的默认网络命名空间,包含所有物理网卡和主机的网络堆栈。
- 容器网络命名空间: 每个容器有自己的网络命名空间,内含虚拟网络接口(veth pair),通过它与宿主机或其他网络命名空间通信。
- veth pair 机制:
- veth pair 是一对虚拟网络接口,类似一根网线的两端,一端连接容器的 Netns,另一端连接主机或网络插件。
- 数据包在容器与主机之间通过 veth pair 传递。
- CNI 插件与 Netns:
- Kubernetes 使用 CNI(Container Network Interface) 插件创建和配置容器的网络命名空间。
- 插件会负责为容器分配 IP 地址、设置路由和防火墙规则。
4.CNI技术
- Flannel:
- 特点:简单、轻量级的 Overlay 网络,适合小型集群。
- 实现方式:使用 VXLAN 或 Host-GW 进行 Pod 网络的 Overlay 实现。
- 场景:适用于简单的 Pod 网络隔离场景。
- Macvlan:MACVLAN是一种Linux虚拟化网卡技术,允许用户在主机的一个物理网卡上配置多个虚拟网卡,创建多个MAC地址,并可以分配IP。 在逻辑上与物理网卡是对等的,因此可以实现容器直接访问物理网络,同时从逻辑和Kernel层来看隔离性和性能最优的方案。 但是MACVLAN基于二层隔离,所以需要二层路由器支持,大多数云服务商不支持,所以混合云上比较难以实现。
- Calico:
- 特点:高性能的路由网络,支持网络策略(Network Policy),无 Overlay。
- 实现方式:基于 BGP 实现路由分发,也支持 eBPF。
- 场景:高性能、大规模集群,复杂的网络策略需求。
- Cilium:
- 特点:基于 eBPF 技术,性能优越,支持动态流量管理和细粒度的安全控制。
- 实现方式:通过 eBPF 实现网络数据包的拦截和处理。
- 场景:需要高性能和复杂网络安全控制的环境。
- Weave Net:
- 特点:支持跨云平台的 Overlay 网络,自动发现节点和 Pod。
- 实现方式:通过 VXLAN 实现 Pod 网络连接。
- 场景:多云环境或需要简单配置的场景。
- Kube-Router:
- 特点:集成网络路由、服务代理和网络策略功能的插件。
- 实现方式:基于 IPVS 提供高效路由。
- 场景:对路由和服务代理性能要求较高的集群。
- NSX-T(VMware 提供):
- 特点:企业级网络方案,支持多租户和高级网络功能。
- 实现方式:通过虚拟化和软件定义网络(SDN)技术实现。
- 场景:需要多租户和复杂网络控制的企业环境。
5.Network Policy
Network Policy 是 Kubernetes 提供的一种网络安全机制,用于控制 Pod 之间的网络通信以及 Pod 与外部服务的访问。
Network Policy 的功能
- 限制 Pod 间的流量:默认情况下,Kubernetes 中 Pod 之间是完全开放的。通过 Network Policy,可以限制哪些 Pod 可以与特定 Pod 通信。
- 管理 Pod 与外部网络的访问:可以定义规则控制 Pod 是否允许访问外部网络或被外部网络访问。
- 提高集群的安全性:防止未经授权的访问和潜在的网络攻击,尤其在多租户环境中。
- 实现多租户隔离:在同一个集群中,确保不同租户的 Pod 流量彼此隔离。
Network Policy 的主要组件
- PodSelector: 定义哪些 Pod 受该策略影响。
- Ingress(入站规则):定义允许哪些流量进入受策略影响的 Pod。
- Egress(出站规则):定义允许哪些流量从受策略影响的 Pod 发出。
- 规则作用范围:规则可以基于命名空间、IP 地址范围、标签等
案例如下:定义了一个 Network Policy,允许某些 Pod(具有 app: frontend 标签)只能接收来自 app: backend 的流量
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: allow-backend
  namespace: default
spec:
  podSelector:
    matchLabels:
      app: frontend
  ingress:
    - from:
        - podSelector:
            matchLabels:
              app: backend
更新策略
- 滚动更新(Rolling Update)策略:最常用的更新策略,默认情况下,Deployment、StatefulSet 和 DaemonSet 都使用滚动更新策略。 逐步替换旧 Pod 为新 Pod,确保服务不中断,可通过 maxSurge 和 maxUnavailable 控制更新速度。
- 重建更新(Recreate)。先删除所有旧版本的 Pod,然后再创建新版本的 Pod。这种更新方式会导致应用在更新过程中出现短暂的不可用
- 分批更新(Partitioned Update)可以指定一个分区值,只有分区号大于等于该值的 Pod 会被更新,而小于该值的 Pod 保持不变。
最佳实践
1.高可用
k8s 中的master和agent节点,不具备自主恢复、选主等特性。通常为了保证集群的高可用,部署多master集群(例如3master 3agent)。 多个master节点,通过etcd集群进行数据同步,保证数据的一致性,启动多个api server。
想要实现master节点自动恢复,通常需要自行实现运维工具。或者使用云厂商的k8s服务。
2.服务质量等级(Qos)
容器不仅运行无状态服务,也可以运行中间件、数据库、定时任务、大模型训练等。如果未设置Qos的话,可能在宿主资源不足时驱逐核心服务,导致问题出现。
服务质量等级(Quality of Service,QoS) 是用于对 Pod 进行分类的机制,用于指导 kubelet 和调度器在资源竞争(如内存、CPU 不足)时如何进行资源分配和驱逐决策。 QoS 通过 Pod 中容器的资源请求(requests)和限制(limits)定义,确保关键工作负载在资源紧张时优先存活。
- Guaranteed(保证级)
- 定义:Pod 中所有容器都必须设置 CPU 和内存的 requests 且等于 limits。
- 特点:资源分配有严格保证,只有当节点内存耗尽且没有更低优先级 Pod 可驱逐时,才可能被驱逐(极少发生)
- 使用场景:对资源稳定性要求极高的关键服务(如数据库、核心业务组件)。
- Burstable(突发级)
- 定义:只设置了 requests,未设置 limits(资源可突发使用至节点剩余资源)或者 requests 小于 limits(资源可在请求值与限制值之间浮动)
- 特点:资源可灵活使用(突发至 limits 或节点剩余资源),当节点资源不足时,优先级低于 Guaranteed,高于 BestEffort。
- 适用场景:大多数普通业务服务(如 API 服务、中间件客户端),需要一定资源保证但可接受短期波动。
- BestEffort(尽力而为级)
- 定义:Pod 中所有容器未设置任何 requests 和 limits(完全不指定资源约束)
- 特点:不保证任何资源,节点资源充足时可使用全部剩余资源;资源不足时,会被优先驱逐。
- 适用场景:低优先级的非关键任务(如临时脚本、日志清理、测试任务、批处理等)。
使用案例
containers:
- name: app
  # 1. Guaranteed(保证级)
  resources:
    requests:
      cpu: "1"    # 请求 1 核 CPU
      memory: "1Gi"  # 请求 1Gi 内存
    limits:
      cpu: "1"    # 限制 1 核 CPU(与 requests 相等)
      memory: "1Gi"  # 限制 1Gi 内存(与 requests 相等)
  # 2. Burstable(突发级)
  resources:
    requests:
      cpu: "0.5"  # 请求 0.5 核
    limits:
      cpu: "1"    # 限制 1 核(requests < limits)
  # 3.BestEffort(尽力而为级)不设置限制
QoS 的核心作用
- 资源驱逐决策:当节点内存不足(OOM)时,kubelet 会按 QoS 等级从低到高驱逐 Pod,顺序为:BestEffort → Burstable(资源使用超过 requests 部分可能被优先) → Guaranteed(最后被考虑)。(注:CPU 不足时不会直接驱逐 Pod,只会限制其 CPU 使用,导致性能下降)。
- 调度优化:调度器会根据 Pod 的 requests 确保节点有足够资源容纳 Pod,Guaranteed 级 Pod 因资源固定,调度更精准。
- 资源隔离:通过 limits 限制 Pod 最大资源使用,避免单个 Pod 耗尽节点资源,影响其他服务。
查看 Pod 的 QoS 等级
kubectl describe pod qos-guaranteed | grep "QoS Class"
# 输出:QoS Class:  Guaranteed
注意事项
- 内存 vs CPU:QoS 对内存的驱逐影响更显著(CPU 不足仅限流,内存不足会直接 OOM 杀死进程)。
- Burstable 级的细分:Burstable 中,资源使用超过 requests 的 Pod 比未超的更容易被驱逐("越超用越危险")。
- 避免过度使用 Guaranteed:Guaranteed 级会独占资源,可能导致节点资源利用率降低(未使用的资源无法被其他 Pod 临时使用)。
3.JVM容器化
JVM容器化后常见的问题
| 场景 | 核心问题 | 根本原因 | 解决方案 | 关键配置/工具 | 效果 |
|---|---|---|---|---|---|
| 1. 容器内存限制导致OOM | 容器因总内存超限被杀死,但JVM堆内存未满。 | JVM未感知容器内存限制;堆外内存(元空间、线程栈、Direct Memory)失控。 | 启用容器感知;精确分配各部分内存;监控堆外内存。 | -XX:+UseContainerSupport, -XX:MaxRAMPercentage, NMT | OOMKilled 归零,内存使用率稳定。 |
| 2. 大对象分配失败 | G1 GC因Humongous对象分配失败触发频繁Full GC,停顿长。 | G1中大对象需要连续Region,易导致碎片和分配失败。 | 换用ZGC;或调整G1 Region大小;对象池化。 | -XX:+UseZGC, -XX:G1HeapRegionSize | Full GC消失,停顿从秒级降至毫秒级。 |
| 3. Native Memory泄漏 | 堆内存稳定,但堆外内存泄漏导致容器OOM。 | DirectByteBuffer等堆外资源未释放。 | 启用NMT监控;限制Direct Memory大小;修复代码。 | -XX:NativeMemoryTracking=detail, -XX:MaxDirectMemorySize | 泄漏问题解决,OOMKilled 归零。 |
| 4. Safepoint阻塞 | P99延迟飙升,但GC停顿时间短,线程阻塞在安全点。 | 偏向锁频繁撤销、JNI调用或长循环阻碍线程进入安全点。 | 禁用偏向锁;优化循环;监控安全点日志。 | -XX:-UseBiasedLocking, -Xlog:safepoint | P99延迟从秒级恢复正常,系统吞吐量提升。 |
| 5. 混合GC失败 | G1混合GC无法有效回收空间,退化为频繁Full GC。 | 并发标记失败、老年代碎片化、晋升失败。 | 调优混合GC相关参数,提高回收效率。 | -XX:G1MixedGCCountTarget, -XX:G1HeapWastePercent | Full GC频率大幅降低,混合GC成功率提升。 |
核心思想与调优方法论
- 从现象到底层:不仅要解决表面问题(如Full GC),更要深入理解其背后的JVM机制(如内存管理、回收算法、线程同步)。
- 监控先行:缺乏有效监控就无法定位问题。强调使用NMT、GC日志、Safepoint日志等工具进行全方位观测。
- 环境适配:在容器化环境中,JVM必须正确感知资源限制(CGroup),并进行精确的内存规划。
- 权衡与选择:根据业务场景(如低延迟、大堆)选择合适的GC器(如ZGC),没有万能的配置。
- 数据驱动:调优应以可量化的指标(如停顿时间、OOM频率)为准绳,用数据验证优化效果。
4.资源限制
容器与宿主机存在层级化的资源约束关系,例如文件描述符、CPU、内存、网络等资源的限制。 例如最大文件打开数量(nofile),容器的文件描述符消耗宿主机内核的全局资源,宿主机系统级上限耗尽后容器会完全无法正常使用; 而进程级 / 用户级限制则是各自独立的,但容器配置可能受宿主机默认值影响。
解决方案:调整宿主机上限,限制容器资源。
1. 修改宿主配置
# 临时设置
echo 2000000 > /proc/sys/fs/file-max
# 永久设置(编辑/etc/sysctl.conf)
echo "fs.file-max = 2000000" >> /etc/sysctl.conf
sysctl -p
2. 限制容器
避免给容器设置过高的 nofile(如 65535),根据实际需求调整(如 Redis 设 10240,Nginx 设 8192),
同时结合 k8s 资源限制(cpu/memory)避免单容器占用过多 FD;
3. 监控资源消耗
4. 避免容器以 root 运行:非 root 用户的 ulimit 限制可进一步降低风险,同时通过 k8s 的runAsUser约束容器用户。
生态
1.Harbor
- 官网:https://goharbor.io/
- 安装教程: https://www.cnblogs.com/pangguoping/p/7650014.html
- 教程:https://blog.csdn.net/robin_cai/article/details/124292678
- 简单的安装教程:https://blog.csdn.net/shawn210/article/details/98068165
1.1.介绍
- Harbor介绍
Harbor是一个用于存储和分发Docker镜像的企业级Registry服务器,通过添加一些企业必需的功能特性,例如安全、标识和管理等,扩展了开源Docker Distribution。 作为一个企业级私有Registry服务器,Harbor提供了更好的性能和安全。提升用户使用Registry构建和运行环境传输镜像的效率。 Harbor支持安装在多个Registry节点的镜像资源复制,镜像全部保存在私有Registry中, 确保数据和知识产权在公司内部网络中管控。 另外,Harbor也提供了高级的安全特性,诸如用户管理,访问控制和活动审计等。
- Harbor特性
- 基于角色的访问控制 :用户与Docker镜像仓库通过"项目"进行组织管理,一个用户可以对多个镜像仓库在同一命名空间(project)里有不同的权限。
- 镜像复制 : 镜像可以在多个Registry实例中复制(同步)。尤其适合于负载均衡,高可用,混合云和多云的场景。
- 图形化用户界面 : 用户可以通过浏览器来浏览,检索当前Docker镜像仓库,管理项目和命名空间。
- AD/LDAP 支持 : Harbor可以集成企业内部已有的AD/LDAP,用于鉴权认证管理。
- 审计管理 : 所有针对镜像仓库的操作都可以被记录追溯,用于审计管理。
- 国际化 : 已拥有英文、中文、德文、日文和俄文的本地化版本。更多的语言将会添加进来。
- RESTful API : RESTful API 提供给管理员对于Harbor更多的操控, 使得与其它管理软件集成变得更容易。
- 部署简单 : 提供在线和离线两种安装工具, 也可以安装到vSphere平台(OVA方式)虚拟设备。
1.2.安装
下载安装包,比如1.10.14 是目前稳定的版本。
- 停止harbor: docker-compose stop
- 启动harbor: docker-compose up -d
配置:https://www.tracymc.cn/archives/1371
基本操作
# 1.登录
docker login -u admin -p Harbor12345 192.168.3.101:9010

# 2.构建镜像 /usr/local/data 目录下有dockerfile,可以自动化进行构建镜像
docker build -t public/my_project:1.0 /usr/local/data

# 3.对本地镜像创建tag
docker tag 1319b1eaa0b7 192.168.3.101:9010/public/my_project:1.0

# 4.推送仓库
docker push 192.168.3.101:9010/public/my_project:1.0

# 5.移除已经运行的容器
docker rm -f my_project

# 6.运行新容器
docker run -d -p 8080:8080 --name=my_project public/my_project:1.0
2.管理系统
k8s 提供了基础的命令行功能,一些复杂的操作还是比较麻烦的,所以需要使用更高级别的管理工具。
k8s 已然是当下容器编排领域事实上的标准,各大云服务商都急于推出 k8s 服务,互联网公司也纷纷跟进,将自己的应用容器化,并使用 k8s 编排。 在 k8s 图形化工具方面,我们已经获得了极大的可选择空间:
- 各云服务商自己推出的 k8s 服务所搭载的管理控制台,例如
- 阿里云的 k8s 服务
- 青云推出的 KubeSphere
- 其他云服务商的 CaaS 类服务
- k8s 官方的图形管理界面 k8s Dashboard
- 面向企业私有化部署的 Rancher
- 行业新星 KuberSphere
2.1.rancher
Rancher 是一个开源的企业级全栈容器部署及管理平台。Rancher 为容器提供了一揽子基础架构服务,CNI 兼容的网络服务,存储服务,主机管理,负载均衡,防护墙。 Rancher让上述服务跨越有云,私有云,虚拟机,物理环境运行,真正实现一键式应用部署和管理。
2.2.KuberSphere
KubeSphere 作为企业级的全栈化容器平台,为用户提供了一个具备极致体验的 Web 控制台,让您能够像使用任何其他互联网产品一样,快速上手各项功能与服务。 目前提供了工作负载管理、微服务治理、DevOps 工程、Source to Image、多租户管理、多维度监控、日志查询与收集、告警通知、服务与网络、应用管理、基础设施管理、镜像管理、应用配置密钥管理等功能模块, 开发了适用于适用于物理机部署 Kubernetes 的 负载均衡器插件 Porter,并支持对接多种开源的存储与网络方案,支持高性能的商业存储与网络服务。
2.3.kuboard
Kubernetes 官方提供的图形界面,是一款免费的Kubernetes图形化管理工具,它力图帮助用户快速在Kubernetes上落地微服务。使用Kuboard,用户无需编写YAML文件,就可以完成应用程序的部署和管理。 Kuboard可以使用内建用户库、gitlab/github单点登录或者LDAP用户库进行认证,避免管理员将 ServiceAccount的Token分发给普通用户而造成的麻烦。 使用内建用户库时,管理员可以配置用户的密码策略、密码过期时间等安全设置。
快速体验:使用docker compose快速安装:https://www.kuboard.cn/v4/install/quickstart.html
登录地址:http://localhost:8000/login
账号密码:admin Kuboard123
3.CoreDNS
DNS是互联网的一项基础服务,提供将域名解析为ip的能力,帮助用户更方便的使用互联网。 除此之外,还提供负载均衡、就近访问、动态变更等功能。 DNS协议属于应用层协议,默认暴露TCP/UDP的53端口。我们的服务器访问网路时会向DNS发送域名查询请求。
CoreDNS是CNCF开源的Kubernetes集群中负责DNS解析的组件,能够支持解析集群内部自定义服务域名和集群外部域名。 CoreDNS具备丰富的插件集,在集群层面支持自建DNS、自定义hosts、CNAME、rewrite等需求。 CoreDNS是Kubernetes集群中负责DNS解析的组件,能够支持解析集群内部自定义服务域名和集群外部域名。 CoreDNS具备丰富的插件集,在集群层面支持自建DNS、自定义hosts、CNAME、rewrite等需求。
DNS 服务器支持正向查找(A 和 AAAA 记录)、端口发现(SRV 记录)、反向 IP 地址发现(PTR 记录)等。
Pod的DNS策略。
- ClusterFirst:这是默认的DNS策略,当Pod需要域名解析时,首先会查询集群内部的CoreDNS服务。
- None:Pod会忽略集群的DNS策略。需要您提供dnsConfig字段来指定其他DNS地址,否则Pod可能无法正确解析任何域名。
- Default:Pod直接继承集群节点的域名解析配置。
- ClusterFirstWithHostNet:强制在hostNetwork网络模式下使用ClusterFirst策略(默认使用Default策略)。
工作流程
- 业务Pod(Pod Client)试图访问Nginx服务(Service Nginx)时。
- 先会请求本地DNS配置文件(/etc/resolv.conf)中指向的DNS服务器(nameserver 172.21.0.10,即Service kube-dns)
- kube-dns服务部署的事CoreDns,解析域名获取服务IP地址,得到解析结果为172.21.0.30的IP地址。
- 业务Pod(Pod Client)再直接发起往该IP地址的请求,请求最终经过Nginx服务(Service Nginx)转发到达后端的Nginx容器(Pod Nginx-1和Pod Nginx-2)上。
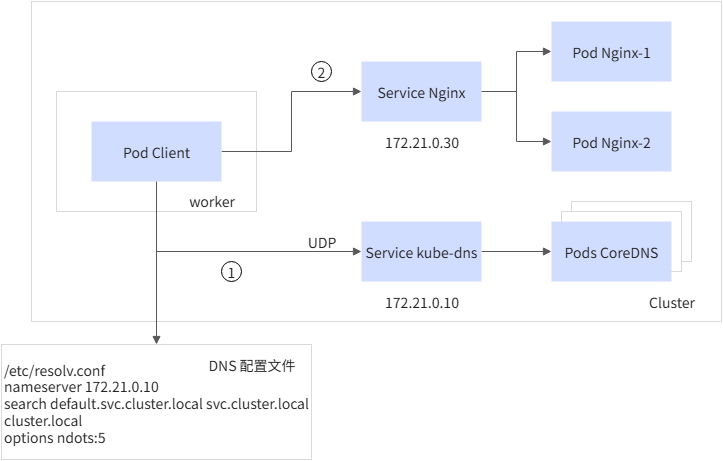
配置文件。CoreDNS 安装时使用如下默认 Corefile 配置。
apiVersion: v1
kind: ConfigMap
metadata:
  name: coredns
  namespace: kube-system
data:
  Corefile: |
    .:53 {
        errors
        health {
            lameduck 5s
        }
        ready
        kubernetes cluster.local in-addr.arpa ip6.arpa {
            pods insecure
            fallthrough in-addr.arpa ip6.arpa
            ttl 30
        }
        prometheus :9153
        forward . /etc/resolv.conf
        cache 30
        loop
        reload
        loadbalance
    }
Corefile 配置包括以下 CoreDNS 插件:
- errors:错误记录到标准输出。
- health:在 http://localhost:8080/health 处提供 CoreDNS 的健康报告。在这个扩展语法中,lameduck 会使此进程不健康,等待 5 秒后进程被关闭。
- ready:在端口 8181 上提供的一个 HTTP 端点, 当所有能够表达自身就绪的插件都已就绪时,在此端点返回 200 OK。
- kubernetes:CoreDNS 将基于服务和 Pod 的 IP 来应答 DNS 查询。你可以在 CoreDNS 网站找到有关此插件的更多细节。
- 你可以使用 ttl 来定制响应的 TTL。默认值是 5 秒钟。TTL 的最小值可以是 0 秒钟, 最大值为 3600 秒。将 TTL 设置为 0 可以禁止对 DNS 记录进行缓存。
- pods insecure 选项是为了与 kube-dns 向后兼容。
- 你可以使用 pods verified 选项,该选项使得仅在相同名字空间中存在具有匹配 IP 的 Pod 时才返回 A 记录。
- 如果你不使用 Pod 记录,则可以使用 pods disabled 选项。
- prometheus:CoreDNS 的度量指标值以 Prometheus 格式(也称为 OpenMetrics)在 http://localhost:9153/metrics 上提供。
- forward: 不在 Kubernetes 集群域内的任何查询都将转发到预定义的解析器 (/etc/resolv.conf)。
- cache:启用前端缓存。
- loop:检测简单的转发环,如果发现死循环,则中止 CoreDNS 进程。
- reload:允许自动重新加载已更改的 Corefile。编辑 ConfigMap 配置后,请等待两分钟,以使更改生效。
- loadbalance:这是一个轮转式 DNS 负载均衡器, 它在应答中随机分配 A、AAAA 和 MX 记录的顺序。
Helm
仓库
- 官方仓库:https://hub.helm.sh/
- 阿里云仓库:https://kubernetes.oss-cn-hangzhou.aliyuncs.com/charts
- 微软云仓库:http://mirror.azure.cn/kubernetes/charts/
- 公共仓库【用于查询helm chart】:https://artifacthub.io/
1.介绍
Helm 是 Kubernetes 的包管理工具,就像 Ubuntu 的 apt、CentOS 的 yum 一样,可以方便地下载、安装、升级、回滚、卸载 Kubernetes 应用。
Helm 的作用
- 应用打包:把 Kubernetes 应用的所有 YAML 配置(Deployment、Service、ConfigMap 等)打包成一个 Chart。
- 版本管理:可以对应用发布进行版本控制(安装、升级、回滚)。
- 依赖管理:Chart 可以依赖其他 Chart(例如一个 Web 应用依赖 Redis Chart)。
- 配置定制:部署时可以通过参数动态替换 YAML 中的配置(无需修改 YAML 文件)。
Helm 的组成(Helm 3 架构) Helm 3 相比 Helm 2 简化了架构,去掉了 Tiller 组件,直接通过 Kubernetes API 与集群交互:
- Helm 客户端(helm CLI):本地命令行工具,负责管理 Chart、Repositories 和 Releases。
- Chart:应用打包的格式,包含应用的 YAML 模板、默认配置等。
- Repository:Chart 仓库(HTTP/HTTPS 服务器),用来存储和分发 Chart。
- Release:在 Kubernetes 集群中运行的 Chart 实例(一个 Chart 可以部署多次,每次是一个 Release)。
2.安装
下面以 Helm 3 为例,Helm 2 已经不再推荐使用。
安装到k8s的master节点。
方式1:二进制安装
1. 到 Helm 官方 Release 页面下载对应版本:
https://github.com/helm/helm/releases

2. 选择对应平台的压缩包(例如 Linux amd64):
wget https://get.helm.sh/helm-v3.14.4-linux-amd64.tar.gz

3. 解压并移动到 PATH 路径:
tar -zxvf helm-v3.14.4-linux-amd64.tar.gz
sudo mv linux-amd64/helm /usr/local/bin/helm

4. 验证安装:
helm version
出现类似:
version.BuildInfo{Version:"v3.14.4", ...}
方式2:包管理器安装
macOS(Homebrew):brew install helm
Ubuntu / Debian:sudo apt-get install helm
CentOS / RHEL:sudo yum install helm
Windows(Chocolatey):choco install kubernetes-helm
配置 Helm(可选):Helm 3 不需要 Tiller,只要 kubectl 能连接集群,Helm 就能用:
kubectl config current-context
如果能看到当前集群上下文,Helm 就可以直接使用。
3.快速使用
1. 添加 Chart 仓库
官方仓库: helm repo add bitnami https://charts.bitnami.com/bitnami
查看已添加仓库:helm repo list
更新仓库索引:helm repo update

2. 搜索 Chart。例如nginx
helm search repo nginx

3. 安装应用,例如Nginx:
helm install my-nginx bitnami/nginx

- my-nginx:Release 名称(自定义)
- bitnami/nginx:Chart 来源(仓库名/chart名)

安装完成后,Helm 会在集群中创建对应的 Deployment、Service 等资源。

4. 查看已安装的 Release
helm list
NAME        NAMESPACE   REVISION    UPDATED                                 STATUS      CHART       APP VERSION
my-nginx    default     1           2025-09-25 10:11:22.345678901 +0800 CST deployed    nginx-15.2.3 1.25.3

5. 查看 Release 详情
helm show values bitnami/nginx       # 查看 Chart 可配置参数
helm get values my-nginx             # 查看当前 Release 的配置
helm get manifest my-nginx           # 查看生成的 Kubernetes YAML

6. 升级 Release:修改参数并升级,例如修改 Service 类型为 NodePort:
helm upgrade my-nginx bitnami/nginx  --set service.type=NodePort

7.  回滚 Release:如果升级后有问题,可以回滚到上一版本:
 helm rollback my-nginx 1
 1 是版本号(从 `helm list -a` 查看)。

8. 卸载 Release:这会删除通过该 Release 创建的所有 Kubernetes 资源。
helm uninstall my-nginx
4.自定义 Chart
如果你想把自己的应用打包成 Helm Chart:
helm create my-app

会生成一个目录结构:
my-app/
├── Chart.yaml
├── values.yaml
├── templates/
│   ├── deployment.yaml
│   ├── service.yaml
│   └── ...
└── charts/

修改模板和配置后,可打包,生成 `.tgz` 文件,可上传到 Chart 仓库。
helm package my-app
5.常用命令速查
helm repo add <repo> <url>      # 添加仓库
helm repo update                # 更新仓库
helm search repo <keyword>      # 搜索 Chart
helm install <release> <chart>  # 安装应用
helm list                       # 查看安装的应用
helm upgrade <release> <chart>  # 升级应用
helm rollback <release> <ver>   # 回滚版本
helm uninstall <release>        # 卸载应用
常见面试题
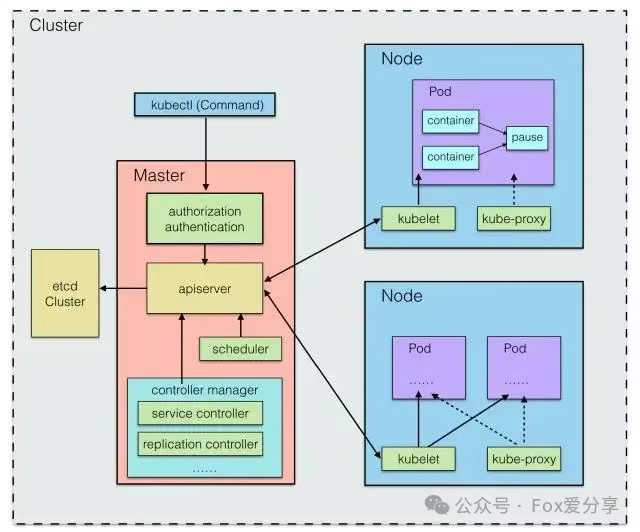
问题一:主节点和工作节点是如何通信的呢?
Master 节点启动时,会运行一个 kube-apiserver 进程,它提供了集群管理的 API 接口,是集群内各个功能模块之间数据交互和通信的中心枢纽, 并且它页提供了完备的集群安全机制。
在 Node 节点上,使用 K8S 中的 kubelet 组件,在每个 Node 节点上都会运行一个 kubelet 进程,它负责向 Master 汇报自身节点的运行情况, 如 Node 节点的注册、终止、定时上报健康状况等,以及接收 Master 发出的命令,创建相应 Pod。
在 K8S 中,Pod 是最基本的操作单元,它与 docker 的容器有略微的不同,因为 Pod 可能包含一个或多个容器(可以是 docker 容器),这些内部的容器是共享网络资源的,即可以通过 localhost 进行相互访问。
关于 Pod 内是如何做到网络共享的,每个 Pod 启动,内部都会启动一个 pause 容器(google的一个镜像),它使用默认的网络模式,而其他容器的网络都设置给它,以此来完成网络的共享问题。

Master 是如何将 Pod 调度到指定的 Node 上的?
该工作由 kube-scheduler 来完成,整个调度过程通过执行一些列复杂的算法最终为每个 Pod 计算出一个最佳的目标 Node, 该过程由 kube-scheduler 进程自动完成。
常见的有轮询调度(RR)。当然也有可能,我们需要将 Pod 调度到一个指定的 Node 上,我们可以通过节点的标签(Label)和 Pod 的 nodeSelector 属性的相互匹配,来达到指定的效果。
各节点、Pod 的信息都是统一维护在哪里的,由谁来维护?
从上面的 Pod 调度的角度看,我们得有一个存储中心,用来存储各节点资源使用情况、健康状态、以及各 Pod 的基本信息等,这样 Pod 的调度来能正常进行。
在 K8S 中,采用 etcd 组件 作为一个高可用强一致性的存储仓库,该组件可以内置在 K8S 中,也可以外部搭建供 K8S 使用。
集群上的所有配置信息都存储在了 etcd,为了考虑各个组件的相对独立,以及整体的维护性,对于这些存储数据的增、删、改、查,统一由 kube-apiserver 来进行调用, apiserver 也提供了 REST 的支持,不仅对各个内部组件提供服务外,还对集群外部用户暴露服务。
外部用户可以通过 REST 接口,或者 kubectl 命令行工具进行集群管理,其内在都是与 apiserver 进行通信。
外部用户如何访问集群内运行的 Pod ?
K8S 引入了 Service 的概念,将多个相同的 Pod 包装成一个完整的 service 对外提供服务,至于获取到这些相同的 Pod,每个 Pod 启动时都会设置 labels 属性, 在 Service 中我们通过选择器 Selector,选择具有相同 Name 标签属性的 Pod,作为整体服务,并将服务信息通过 Apiserver 存入 etcd 中,该工作由 Service Controller 来完成。 同时,每个节点上会启动一个 kube-proxy 进程,由它来负责服务地址到 Pod 地址的代理以及负载均衡等工作。
Pod 如何动态扩容和缩放?
K8S 中通过 Replication Controller 来进行管理,为每个 Pod 设置一个期望的副本数,当实际副本数与期望不符时,就动态的进行数量调整,以达到期望值。 期望数值可以由我们手动更新,或自动扩容代理来完成。
各个组件之间是如何相互协作的?
ectd 是作为集群数据的存储中心, apiserver 是管理数据中心,作为其他进程与数据中心通信的桥梁。 而 Service Controller、Replication Controller 这些统一交由 kube-controller-manager 来管理, kube-controller-manager 作为一个守护进程,每个 Controller 都是一个控制循环,通过 apiserver 监视集群的共享状态,并尝试将实际状态与期望不符的进行改变。
关于 Controller,manager 中还包含了 Node 节点控制器(Node Controller)、资源配额管控制器(ResourceQuota Controller)、命名空间控制器(Namespace Controller)等。
不同的k8s节点间是如何实现网络通讯的?
- 基于loadbalancer的service分配公网IP,用于网络通讯。
- 基于NodePort的service,将k8s所有节点都配置到SLB中实现公网IP的代理。
- 基于ingress绑定公网IP。
- 基于CNI插件,在k8s集群内部署一个overlay网络,例如Flannel、MACVLAN等。(同一个VPC下可以直接访问)
- VPN。两个私有网络之间可以实现。
- Kubernetes 联邦(Federation)。部署联邦控制平面,将两个集群加入联邦;创建FederatedService,自动在成员集群同步服务配置。 跨集群 Pod 通过联邦服务名访问(如service-name.federation-namespace.svc)。
- 服务网格(Service Mesh)。两个集群部署同一套 Service Mesh 控制平面(或通过联盟模式互联),数据平面(Sidecar)负责跨集群流量转发。 服务发现通过 Mesh 的控制平面同步,Pod 通过服务名访问(无需关心集群边界)。
总结:基于公网(service、ingress)、基于私有网络(CNI插件、VPN)、基于联邦(Federation)和基于服务网格(Service Mesh)。
- 本文作者:zhangxue
- 本文链接:https://lucksnow1989.github.io/article/5.云原生&云服务/3.k8s.html
- 版权声明:本文为本人原创文章,遵循 CC 4.0 BY-NC-SA版权协议,转载请附上原文出处链接和本声明。